生成AIパスポート › Web参考書 › 第5章

言語モデル(LM)と大規模言語モデル(LLM):プレトレーニング、ハイパーパラメータ、Temperature、Top-p

第5章 テキスト生成AIのプロンプト制作と実例 / 節 1

シラバスのキーワード: LMn-gramモデルニューラル言語モデルLLMトークンコンテキストウィンドウプレトレーニングハイパーパラメータTemperatureTop-pプロンプトプロンプトエンジニアリング

本文を読んだあと、覚えているか確認してください。

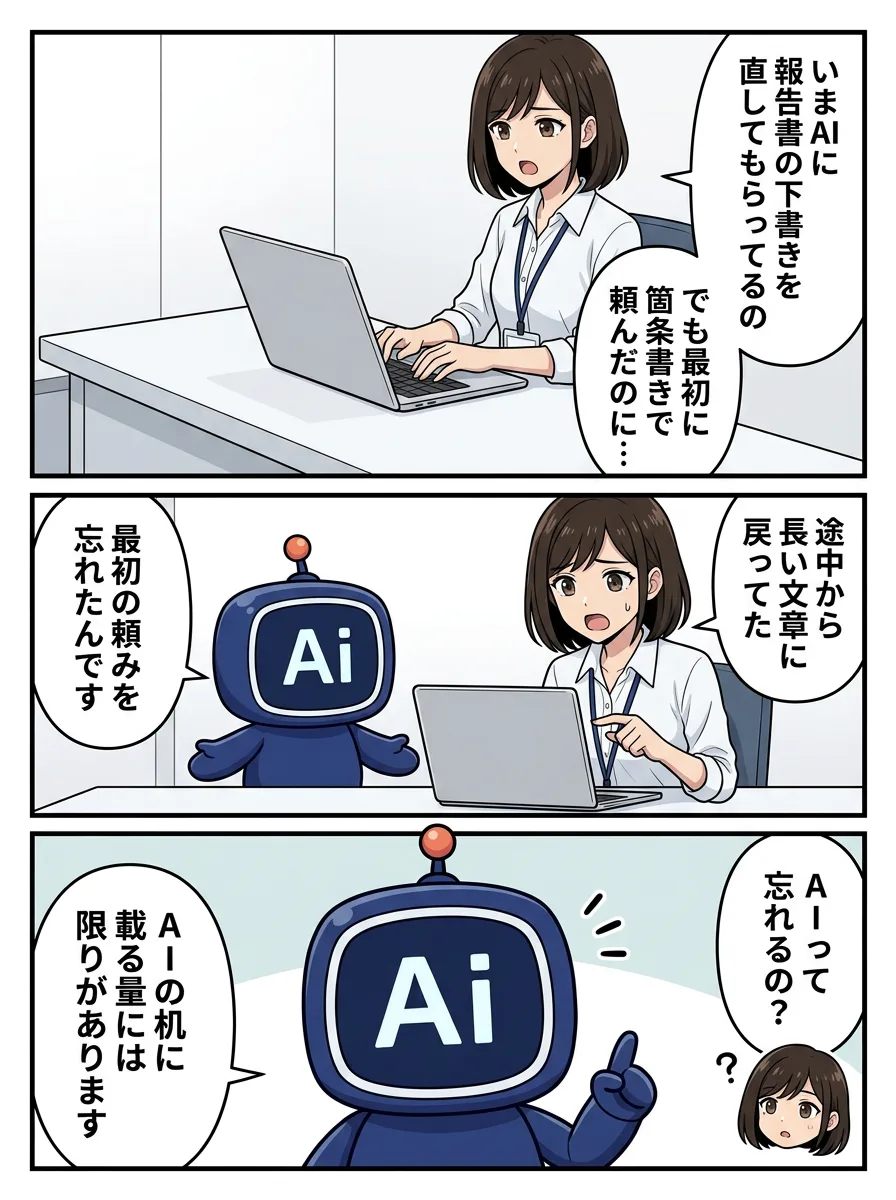
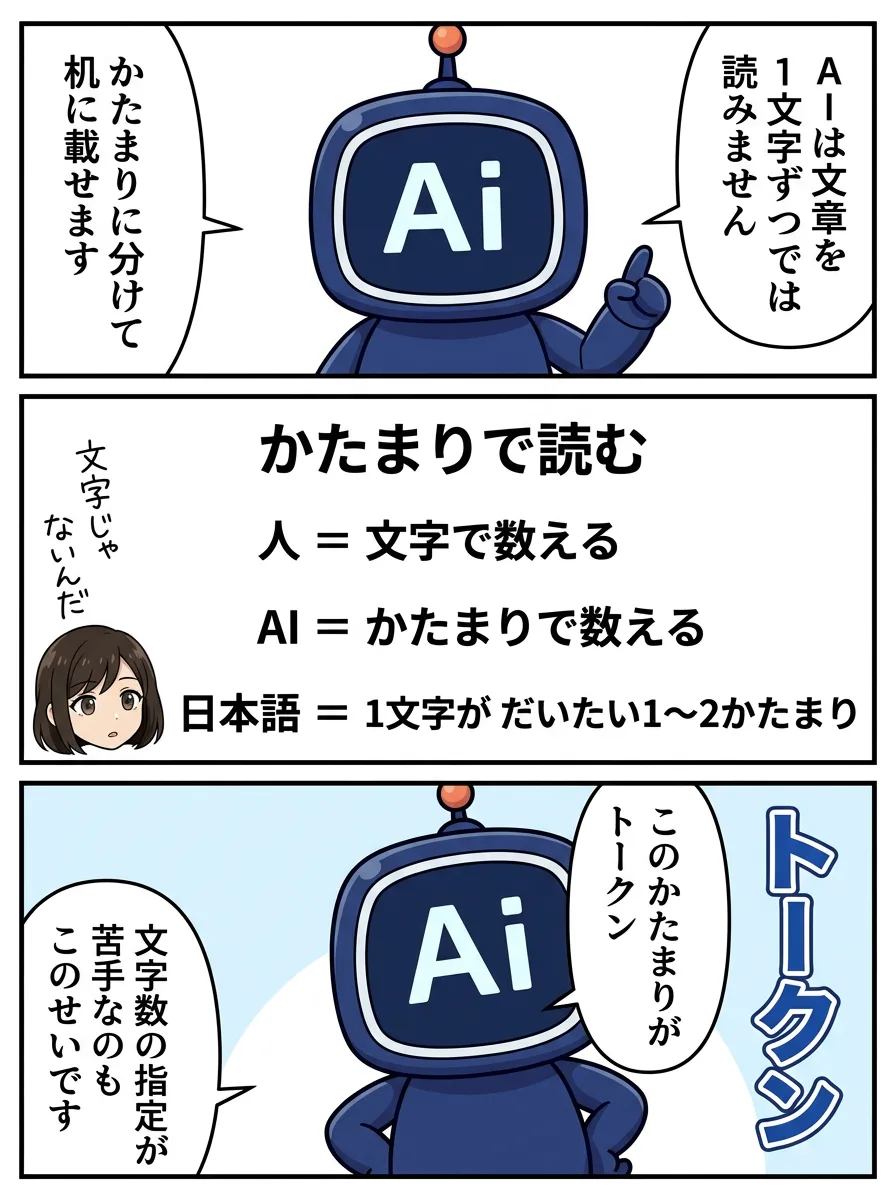
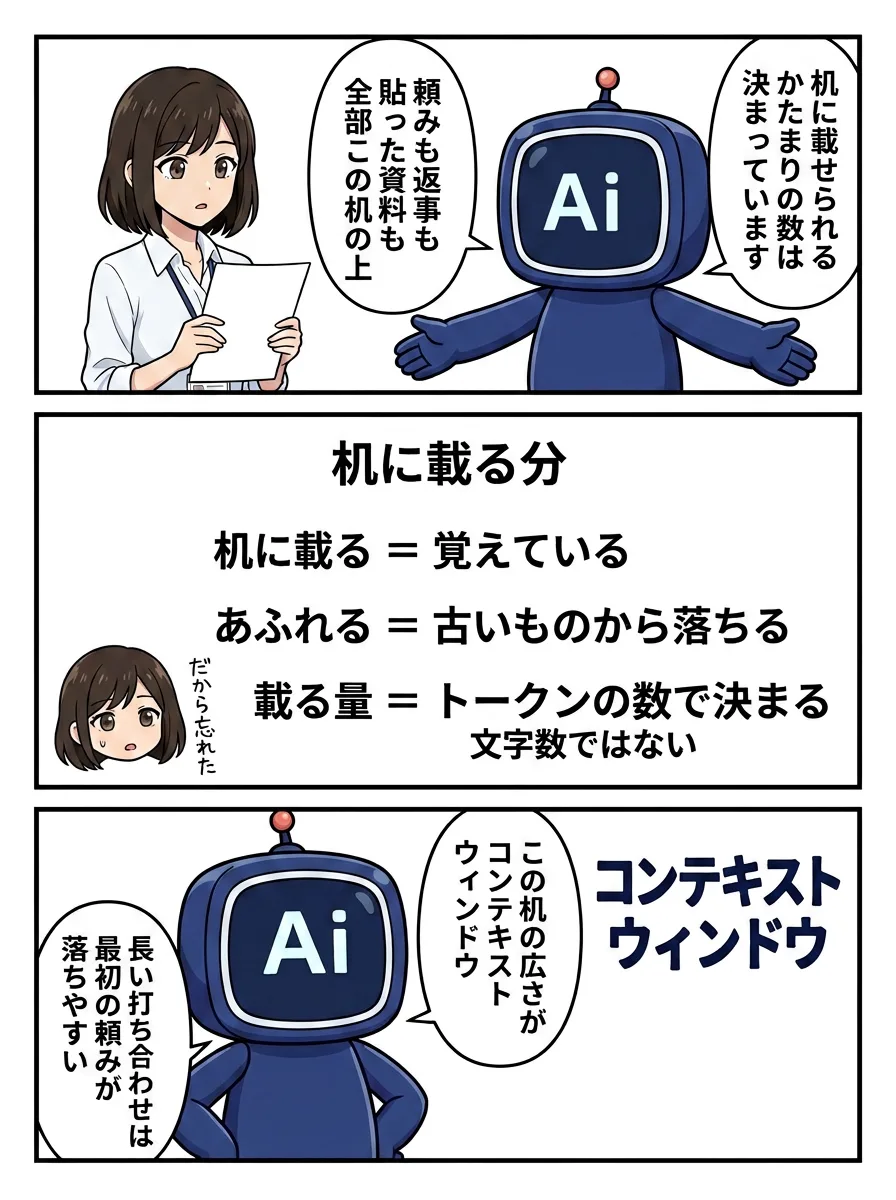
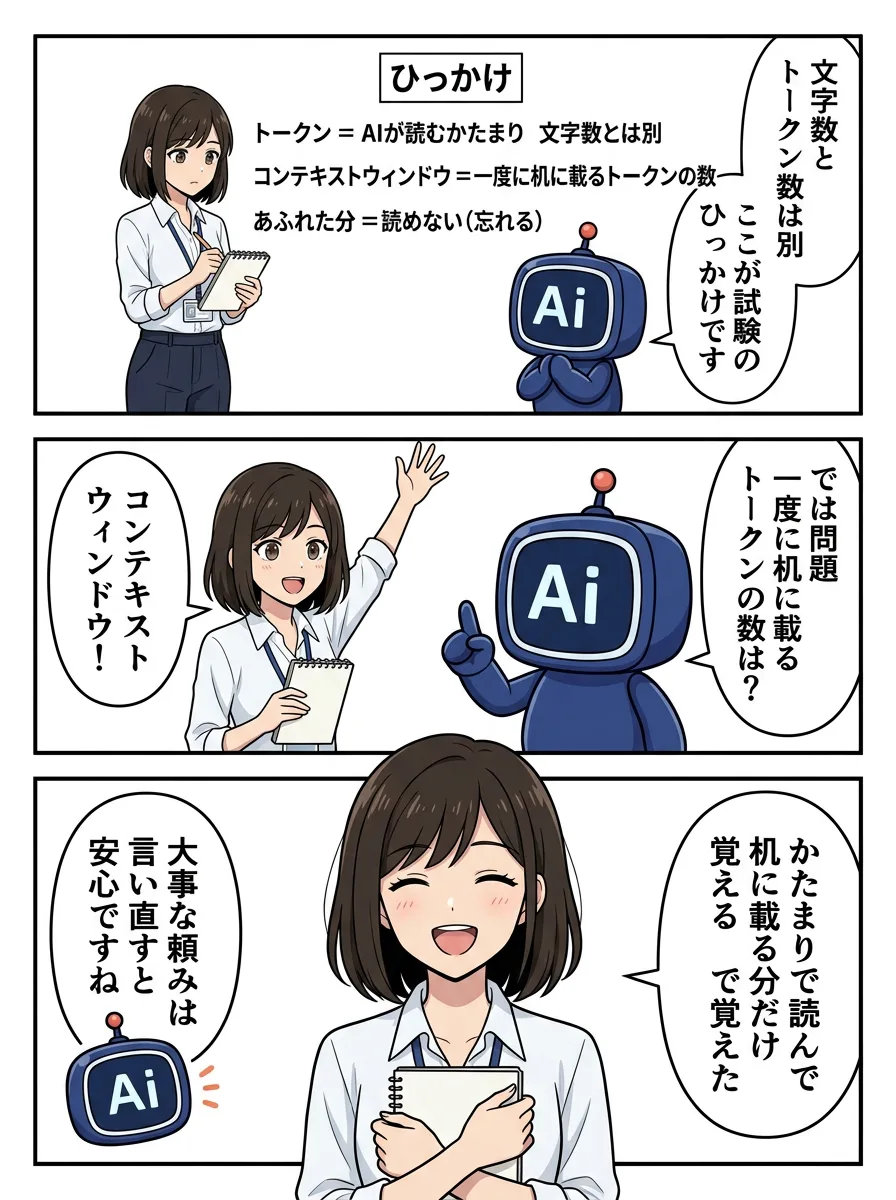
マンガで学ぶ トークンとコンテキストウィンドウ

Ai と みお の4ページ。上から順に読んでください。

トークンとコンテキストウィンドウの解説マンガ 1/4ページトークンとコンテキストウィンドウの解説マンガ 2/4ページトークンとコンテキストウィンドウの解説マンガ 3/4ページトークンとコンテキストウィンドウの解説マンガ 4/4ページ

このマンガのページ マンガ一覧

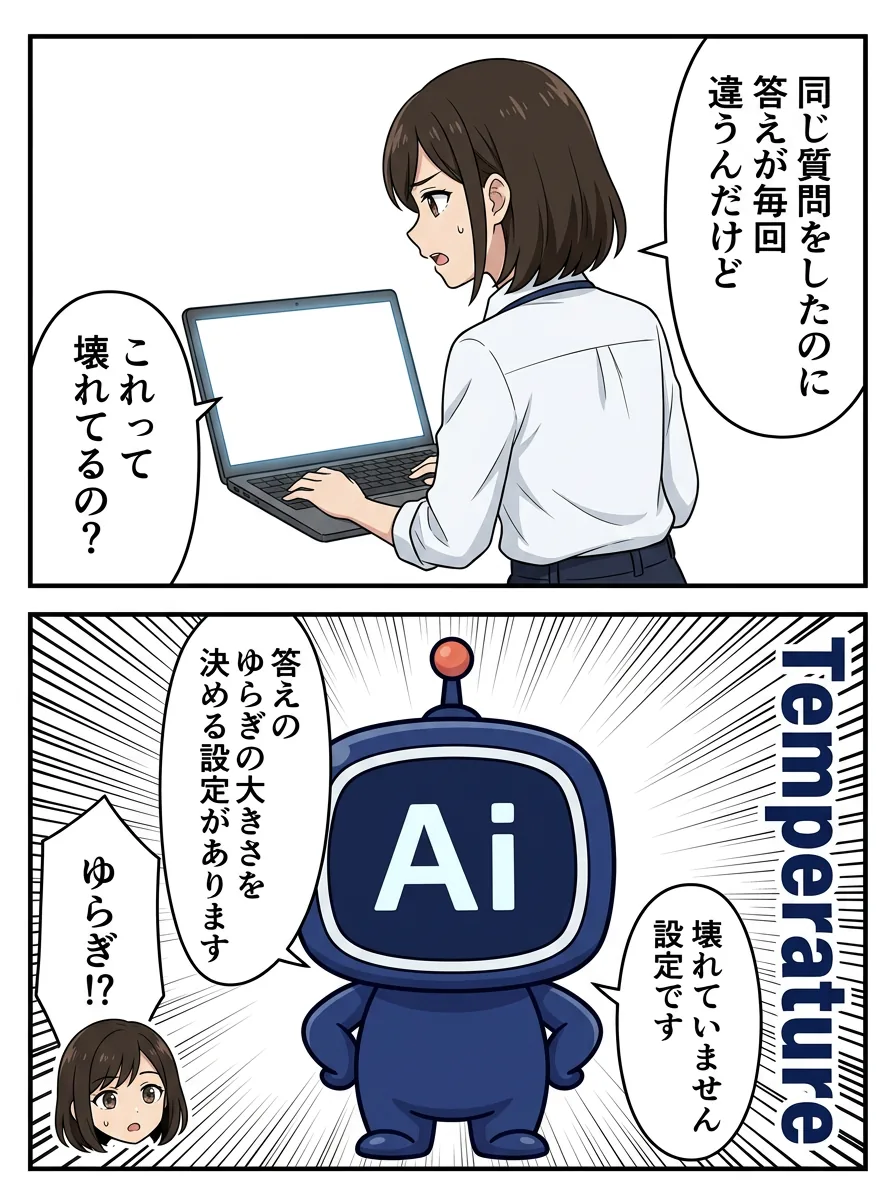
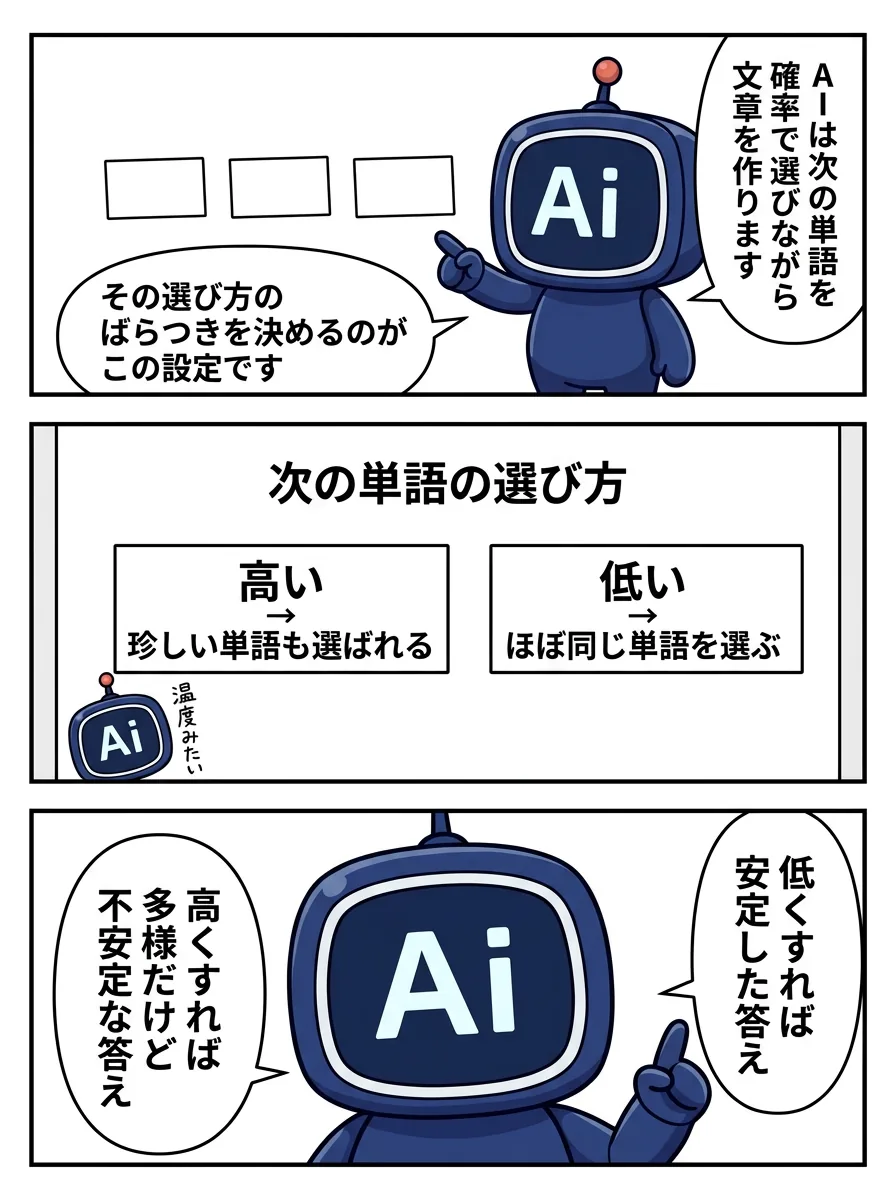
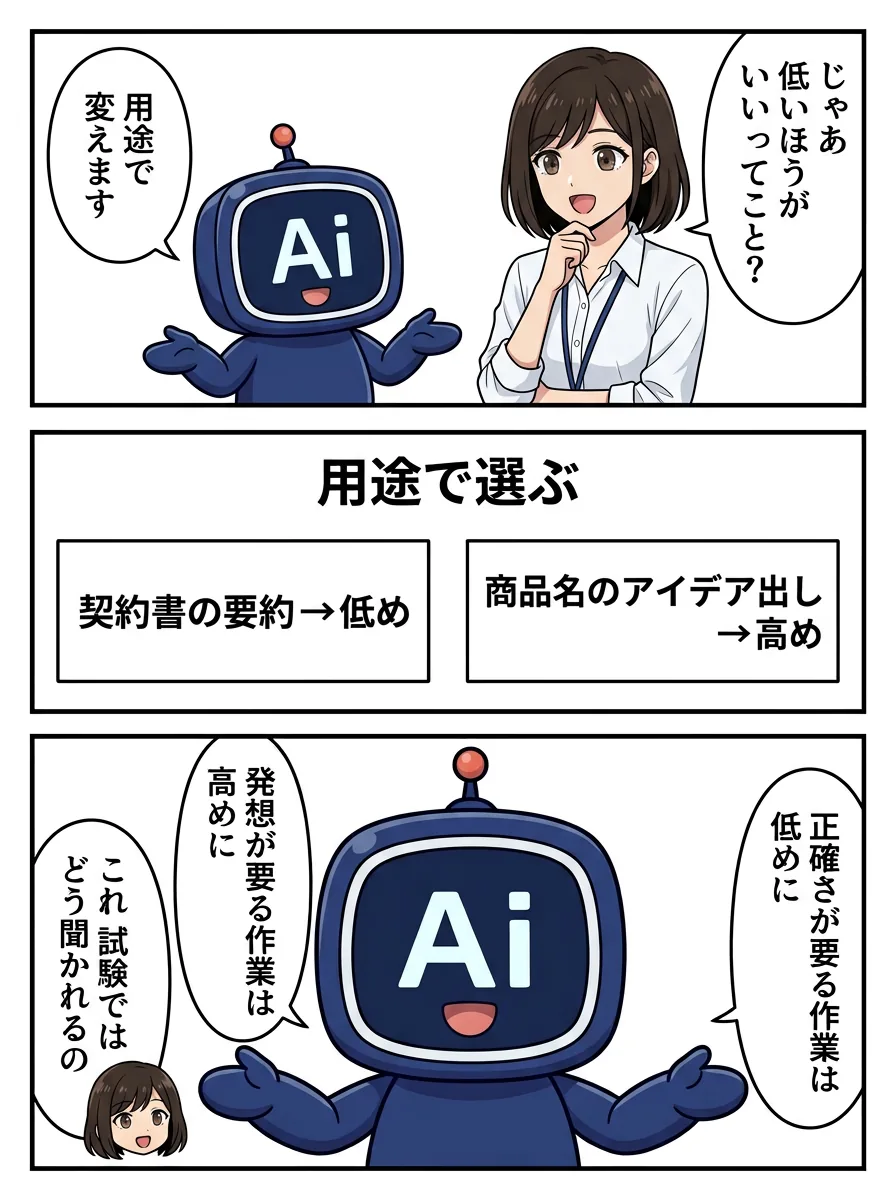
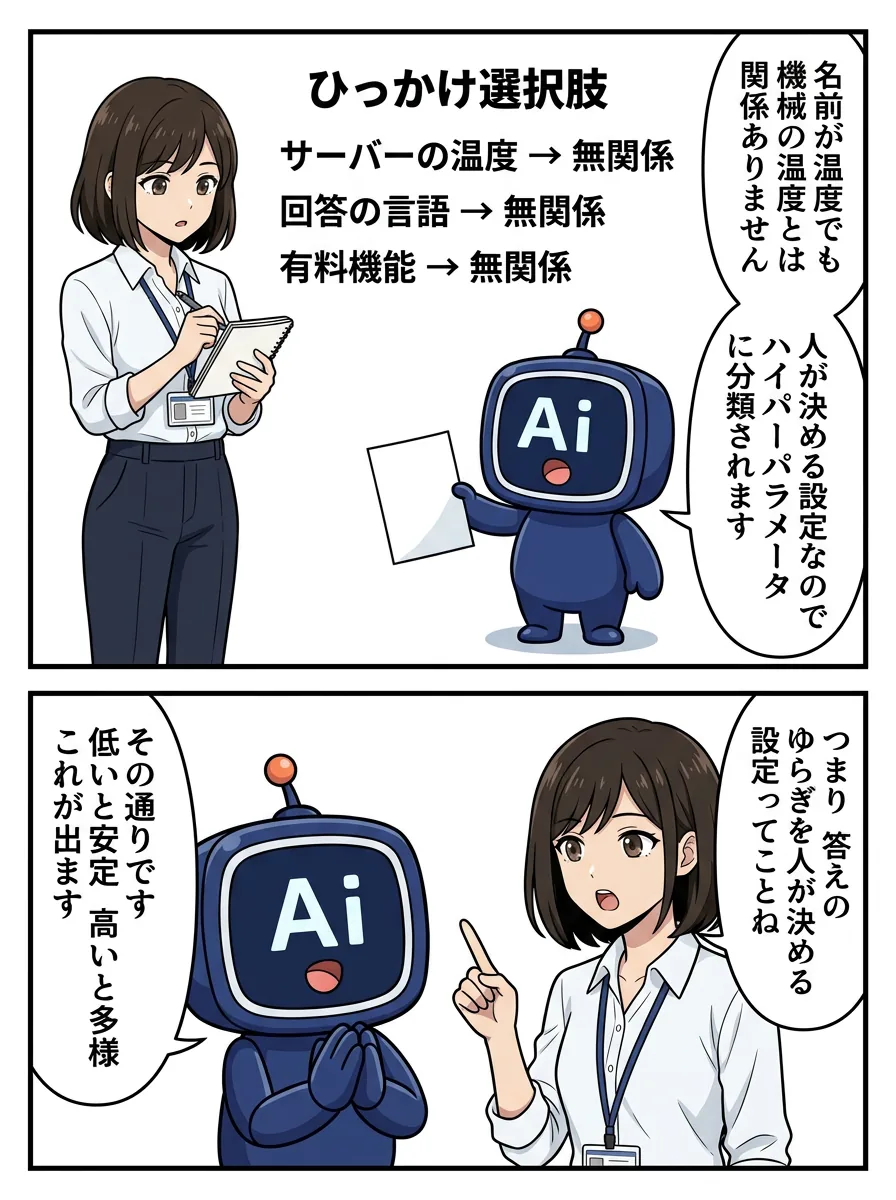
マンガで学ぶ Temperature

Ai と みお の4ページ。上から順に読んでください。

Temperatureの解説マンガ 1/4ページTemperatureの解説マンガ 2/4ページTemperatureの解説マンガ 3/4ページTemperatureの解説マンガ 4/4ページ

このマンガのページ マンガ一覧

言語モデルとは

**言語モデル(LM: Language Model)**は、単語の並びに対して「次に来る単語の確率」を予測するモデルです。この予測を繰り返すことで文章を生成します。

世代 内容
n-gram モデル 直前の n-1 個の単語から次の単語の出現確率を統計的に求める古典的な言語モデル。単純だが長い文脈を考慮できない
ニューラル言語モデル ニューラルネットワークで単語の確率を予測。文脈をより広く扱える
大規模言語モデル(LLM) Transformer を基盤に、巨大なデータとパラメータで学習した言語モデル。GPT、Claude、Gemini など

トークンとコンテキストウィンドウ

言語モデルは文章を1文字ずつではなく、トークンという単位(モデルごとの分割ルールで決まる「かたまり」)に分けて扱います。日本語はおおむね1文字が1〜2トークン、英語は1単語が1トークン前後で、文字数とトークン数は一致しません。生成AIが「ちょうど100字で」のような文字数の指定を守れないのは、トークン単位で生成しているためです。

コンテキストウィンドウは、モデルが一度に扱えるトークン数の上限です。利用者の指示、AI の返答、貼り付けた資料がすべてこの枠に含まれ、上限を超えた分は処理されません。チャットでは古いやり取りから切り捨てられるのが一般的で、長い会話で最初の指示が守られなくなるのはこのためです。上限は「学習データの量」や「パラメータ数」とは別の値です。2027年改訂シラバスでは「トークン化」「次トークン予測」「コンテキストウィンドウ」が生成プロセスの項目として明記されます。

プレトレーニング

**プレトレーニング(事前学習)**は、インターネット上の文章など大量のテキストを使って、次の単語を予測する課題を通じて言語の一般的なパターン(文法、知識、文脈の扱い)を学習させる最初の段階です。GPT の「P」は Pre-trained を意味します。その後、特定用途向けの微調整(ファインチューニング)や、人間の好みに合わせる調整(RLHF)が行われます。

パラメータとハイパーパラメータ

誰が決めるか 例
パラメータ 学習によってモデル自身が獲得する 重み、バイアス
ハイパーパラメータ 学習や推論の前に人間が設定する 学習率、層の数、バッチサイズ、Temperature

値の大小や用途で区別されるものではありません。

Temperature と Top-p

生成AIの出力のランダム性(多様性)を調整する代表的な設定です。

サーバーの温度や回答言語、文字の大文字化、有料機能とは無関係です。

プロンプトとプロンプトエンジニアリング

プロンプトは生成AIへの指示文です。プロンプトエンジニアリングは、指示の書き方、役割の設定、例の提示、出力形式の指定などを工夫して、生成AIから目的に合った質の高い出力を得る技術で、利用者側の技能として誰でも身につけられます。モデル自体の開発やサーバー設計とは別のものです。

試験で問われる観点

この節の練習問題(16問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    言語モデル(LM: Language Model)の基本的な働きとして、最も適切なものを1つ選びなさい。
    1. 1単語の並びに対して、次に来る単語の確率を予測する
    2. 2文章を画像に変換する
    3. 3文法の誤りを人間に代わって採点する専用ソフトである
    4. 4文章を暗号化して保存する
    答えと解説

    正解: 1

    言語モデルは、ある単語の列が与えられたときに次にどの単語が来るかの確率を計算するモデルです。この「次の単語の予測」を繰り返すことで文章を生成します。大規模言語モデル(LLM)は、この仕組みを巨大なデータとパラメータで実現したものです。画像への変換、文法の採点専用ソフト、暗号化は言語モデルの基本的な働きではありません。

  2. 問2
    「n-gramモデル」の説明として、最も適切なものを1つ選びなさい。
    1. 1文中の各単語をn次元の実数ベクトルに変換し、意味の近さを内積で求める分散表現モデル
    2. 2直前のn-1個の単語から次の単語の出現確率を統計的に求める、古典的な言語モデル
    3. 3直前のn個の単語を隠れ状態に圧縮し、文脈を保持しながら次の単語を予測する再帰型モデル
    4. 4文章をn文字ごとに区切って数え上げ、出現頻度の高い文字列を辞書に登録する圧縮モデル
    答えと解説

    正解: 2

    n-gramモデルは、連続するn個の単語の出現頻度を数え、直前のn-1個の単語から次の単語の確率を求める統計的な言語モデルです。仕組みが単純な反面、長い文脈を考慮できない弱点があり、その後ニューラル言語モデル、さらにTransformerを用いた大規模言語モデルへと発展しました。画像や音声の生成、層の数の話ではありません。

  3. 問3
    大規模言語モデル(LLM)の「プレトレーニング(事前学習)」の説明として、最も適切なものを1つ選びなさい。
    1. 1特定の企業や業務に合わせた少量のデータを使って、事前学習済みのモデルを微調整する最後の段階
    2. 2人間が作成した模範回答や好みの評価を使って、モデルの出力を人間の意図に沿うよう調整する段階
    3. 3インターネット上の文章など大量のテキストを使って、言語の一般的なパターンを学習させる最初の段階
    4. 4利用者が質問を入力する前に、モデルに役割や前提条件を与えて回答の形式を整えておく段階
    答えと解説

    正解: 3

    プレトレーニングは、大量のテキストデータから次の単語を予測する課題を通じて、文法や知識、文脈の扱い方など言語の一般的なパターンを学習させる最初の段階です。GPTの「P」はPre-trainedを意味します。その後、特定用途向けの微調整(ファインチューニング)や、人間の好みに合わせる調整(RLHF)が行われます。電源投入や削除は無関係で、特定企業向けの微調整はファインチューニングです。

  4. 問4
    「ハイパーパラメータ」と「パラメータ」の違いの説明として、最も適切なものを1つ選びなさい。
    1. 1ハイパーパラメータは学習中に自動で調整される学習率や勾配の値で、パラメータは学習の前後で変化しない層の数やノード数を指す
    2. 2ハイパーパラメータは画像や音声などの非構造化データを扱う際の設定値で、パラメータはテキストや表形式データを扱う際の設定値である
    3. 3ハイパーパラメータは重みやバイアスなど学習によってモデル自身が獲得する値で、パラメータは学習率や層の数など学習前に人間が設定する値である
    4. 4ハイパーパラメータは学習率や層の数など学習前に人間が設定する値で、パラメータは重みなど学習によってモデル自身が獲得する値である
    答えと解説

    正解: 4

    パラメータは、重みやバイアスのように学習の過程でモデルが自動的に調整する値です。ハイパーパラメータは、学習率、層の数、バッチサイズ、生成時のTemperatureなど、学習や推論の前に人間が設定する値で、モデルの性能や振る舞いに影響します。値の大小や用途の違いで区別されるものではなく、同じものでもありません。

  5. 問5
    生成AIの「Temperature(温度)」の設定を低くした場合の効果として、最も適切なものを1つ選びなさい。
    1. 1出力のランダム性が下がり、毎回似た、確率の高い無難な回答になりやすい
    2. 2生成できる文字数の上限が下がり、短く要約された回答になりやすい
    3. 3出力の多様性が上がり、毎回異なる、意外性のある回答になりやすい
    4. 4参照する文脈の範囲が狭まり、直前の質問だけに基づく回答になりやすい
    答えと解説

    正解: 1

    Temperatureは、次の単語を選ぶ際のランダム性を調整するハイパーパラメータです。低くすると確率の高い単語が選ばれやすくなり、安定した一貫性のある回答になります。高くすると多様で創造的だが不安定な回答になります。要約や事実の整理では低め、アイデア出しでは高めが向いています。多様性が上がるのは高くした場合の効果で、生成できる文字数の上限や参照する文脈の範囲はTemperatureとは別の設定です。

  6. 問6
    「Top-p(nucleus sampling)」の説明として、最も適切なものを1つ選びなさい。
    1. 1p個のプロンプトを1回の要求で同時に処理し、それぞれの回答の中から最も確率の高いものを最終出力として選ぶ方法
    2. 2次の単語の候補を確率の高い順に並べ、累積確率がpに達するまでの候補の中から選ぶことで、出力の多様性を調整する方法
    3. 3次の単語の候補を確率の高い順に並べ、上位p個の候補の中からランダムに選ぶことで、出力の多様性を調整する方法
    4. 4次の単語の確率分布の形を値pで平坦にしたり尖らせたりして、確率の低い単語の選ばれやすさを調整する方法
    答えと解説

    正解: 2

    Top-pは、確率の高い候補から順に累積確率がp(例えば0.9)に達するまでを候補集合とし、その中からサンプリングする方法です。確率の極端に低い単語を除外しつつ多様性を保てるため、Temperatureとともに出力の調整に使われます。大文字化、有料機能、同時処理とは無関係です。

  7. 問7
    「プロンプトエンジニアリング」の説明として、最も適切なものを1つ選びなさい。
    1. 1生成AIを動かすサーバーや推論基盤を、応答速度とコストの両面から最適に設計する工学分野
    2. 2生成AIに入力する画像や音声を、モデルが読み取りやすい形式に前処理して変換する技術
    3. 3生成AIから望ましい出力を引き出すために、指示文(プロンプト)の書き方や構成を工夫する技術
    4. 4生成AIの出力精度を高めるために、モデルの重み(パラメータ)を追加データで再学習させる技術
    答えと解説

    正解: 3

    プロンプトエンジニアリングは、指示の書き方、役割の設定、例の提示、出力形式の指定などを工夫して、生成AIから目的に合った質の高い出力を得る技術です。モデル自体の開発やサーバー設計、画像加工とは異なり、利用者側の技能として誰でも身につけられます。

  8. 問8
    契約書の条文を正確に要約する用途と、新商品の名前のアイデアを大量に出す用途で、Temperatureの設定として適切な組み合わせを1つ選びなさい。
    1. 1要約: 高め、アイデア出し: 低め
    2. 2要約: 高め、アイデア出し: 高め
    3. 3要約: 低め、アイデア出し: 低め
    4. 4要約: 低め、アイデア出し: 高め
    答えと解説

    正解: 4

    正確さと一貫性が求められる要約ではTemperatureを低めにして安定した出力を得るのが適切です。多様な案を求めるアイデア出しではTemperatureを高めにして創造性を引き出します。両方を最大にすると要約が不安定になり、両方を0に固定するとアイデアの幅が狭くなります。

  9. 問9
    言語モデル(LM)が行っていることの説明として、最も適切なものを1つ選びなさい。
    1. 1あらかじめ人間が用意した回答文の一覧から、質問に最も近いものを検索して返す
    2. 2文字を1文字ずつ数えながら、指定された文字数にぴったり合う文章を計算で作る
    3. 3単語の並びに対して次に来る単語の確率を予測し、それを繰り返して文章を生成する
    4. 4文章の意味を人間と同じように理解し、辞書に登録された定義を参照して回答を組み立てる
    答えと解説

    正解: 3

    言語モデルは、単語の並びに対して「次に来る単語の確率」を予測するモデルで、この予測を繰り返して文章を生成します。意味を人間と同じように理解しているわけでも、回答文の一覧から検索しているわけでもなく、文字を数えて計算しているわけでもありません。

  10. 問10
    言語モデルの発展の順序として、最も適切なものを1つ選びなさい。
    1. 1大規模言語モデル(LLM) → n-gramモデル → ニューラル言語モデル
    2. 2ニューラル言語モデル → 大規模言語モデル(LLM) → n-gramモデル
    3. 3n-gramモデル → 大規模言語モデル(LLM) → ニューラル言語モデル
    4. 4n-gramモデル → ニューラル言語モデル → 大規模言語モデル(LLM)
    答えと解説

    正解: 4

    言語モデルは、直前のn-1個の単語から統計的に次の単語の確率を求めるn-gramモデル、ニューラルネットワークで確率を予測するニューラル言語モデル、Transformerを基盤に巨大なデータとパラメータで学習した大規模言語モデル(LLM)の順に発展しました。

  11. 問11
    プレトレーニング(事前学習)の説明として、最も適切なものを1つ選びなさい。
    1. 1大量のテキストで次の単語を予測する課題を通じて、言語の一般的なパターンを学習させる最初の段階
    2. 2特定の用途に合わせた追加データで再学習を行い、モデルを用途に特化させる段階
    3. 3推論時にTemperatureなどの設定値を調整して、出力のランダム性を決める作業
    4. 4人間が応答を評価して順位付けし、その評価をもとに強化学習で調整する段階
    答えと解説

    正解: 1

    プレトレーニングは、インターネット上の文章など大量のテキストを使って、次の単語を予測する課題を通じて文法・知識・文脈の扱いといった言語の一般的なパターンを学習させる最初の段階です。GPTの「P」はPre-trainedを意味します。用途に特化させる再学習はファインチューニング、推論時の設定はハイパーパラメータの調整、人間の評価による調整はRLHFの説明です。

  12. 問12
    同じ生成AIを「契約書の要約」と「新商品のネーミング案出し」に使う。Temperatureの設定として最も適切な組み合わせを1つ選びなさい。
    1. 1どちらも0にして、常に同じ出力になるようにし、案の数は増やさない
    2. 2契約書の要約は低めにして安定した出力を得て、ネーミング案出しは高めにして多様な案を得る
    3. 3契約書の要約は高めにして創造的な表現を得て、ネーミング案出しは低めにして同じ案を繰り返させる
    4. 4どちらも最大にして、常に最も多様で予測しにくい出力を得る
    答えと解説

    正解: 2

    Temperatureは出力のランダム性を調整する設定で、低くすると確率の高い単語が選ばれやすくなり安定した出力に、高くすると多様で創造的だが不安定な出力になります。正確さが要る要約は低め、多様性が要るアイデア出しは高めが向きます。両方を最大にすると要約が不安定になり、両方を0にするとアイデア出しで案の幅が出ません。

  13. 問13
    Top-p(nucleus sampling)の説明として、最も適切なものを1つ選びなさい。
    1. 1モデルのパラメータ数をp%だけ減らして軽量化し、応答速度を上げる代わりに精度をわずかに下げる設定
    2. 2学習データのうち品質の高い上位p%だけを使って再学習し、回答の正確さと一貫性を高めるための設定
    3. 3候補を確率の高い順に並べ、累積確率がpに達するまでの候補から選ぶことで、低確率の単語を除外しつつ多様性を保つ設定
    4. 4出力できる文章の長さの上限をp文字に制限し、それを超えた分を自動的に切り捨てて短い回答にそろえる設定
    答えと解説

    正解: 3

    Top-pは、次の単語の候補を確率の高い順に並べ、累積確率がp(例: 0.9)に達するまでの候補の中から選ぶ設定で、極端に確率の低い単語を除外しつつ多様性を保てます。Temperatureと並んで出力のランダム性を調整する代表的な設定です。文章の長さの制限、パラメータの削減、学習データの絞り込みではありません。

  14. 問14
    Temperatureに関する記述として、不適切なものを1つ選びなさい。
    1. 1出力のランダム性(多様性)を調整する設定である
    2. 2低くすると確率の高い単語が選ばれやすくなり、安定した一貫性のある回答になる
    3. 3高くすると多様で創造的だが、不安定な回答になる
    4. 4AIが動作しているサーバーの温度を監視し、過熱時に応答を止める設定である
    答えと解説

    正解: 4

    Temperatureは出力のランダム性を調整する設定で、低いと安定、高いと多様になります。サーバーの温度や回答言語、文字の大文字化、有料機能とは無関係で、「サーバーの温度を監視する設定」という記述は誤りです。

  15. 問15
    パラメータとハイパーパラメータの違いの説明として、最も適切なものを1つ選びなさい。
    1. 1パラメータは学習でモデルが獲得する値(重みなど)、ハイパーパラメータは学習や推論の前に人間が設定する値
    2. 2パラメータは学習や推論の前に人間が設定する値、ハイパーパラメータは学習によってモデル自身が獲得する値
    3. 3パラメータは値の小さいものを指し、ハイパーパラメータは値の大きいものを指すという大小による区別である
    4. 4パラメータは文章生成に使う値、ハイパーパラメータは画像生成に使う値という用途による区別である
    答えと解説

    正解: 1

    パラメータは重みやバイアスのように学習によってモデル自身が獲得する値で、ハイパーパラメータは学習率、層の数、バッチサイズ、Temperatureのように学習や推論の前に人間が設定する値です。両者を逆にした説明や、値の大小、用途で区別する説明は誤りです。

  16. 問16
    プロンプトエンジニアリングに関する記述として、不適切なものを1つ選びなさい。
    1. 1モデル自体の開発やサーバーの設計とは別のものである
    2. 2モデルの内部のパラメータを書き換える技術であり、AI開発者だけが行える
    3. 3指示の書き方、役割の設定、例の提示、出力形式の指定などを工夫して、目的に合った質の高い出力を得る技術である
    4. 4利用者側の技能であり、誰でも身につけることができる
    答えと解説

    正解: 2

    プロンプトエンジニアリングは、指示の書き方や役割の設定、例の提示、出力形式の指定などを工夫して質の高い出力を得る、利用者側の技能です。モデルの内部のパラメータを書き換える技術ではなく、開発者だけが行えるものでもないため、その記述は不適切です。