RAGとは
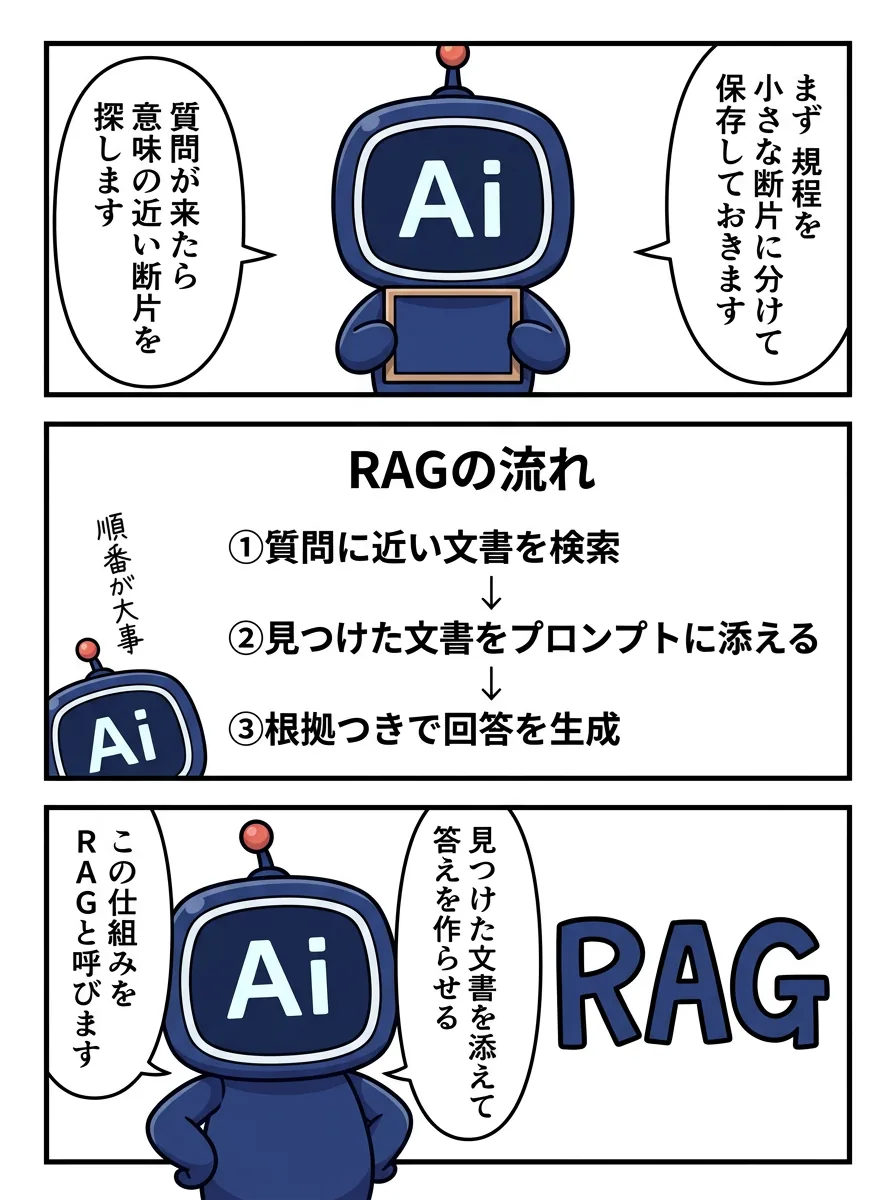
**RAG(Retrieval-Augmented Generation、検索拡張生成)は、言語モデルが回答を生成する前に、質問に関連する情報を社内文書やデータベースなどから検索(Retrieval)し、その内容をプロンプトに加えて(Augmented)回答を生成(Generation)**させる仕組みです。モデルを再学習せずに、最新情報や社内固有の情報を回答に反映できます。
2020年に Meta(当時 Facebook)の研究者らが発表した論文で提案され、ChatGPT の普及に伴い、2023年以降に企業での導入が急増しました。
処理の流れ
事前準備
- マニュアルや規程などの文書を、段落や一定の文字数ごとの断片(チャンク)に分割する。
- 各チャンクを埋め込みモデルで数値ベクトルに変換し、ベクトルデータベースに保存する。
質問時 3. 利用者の質問もベクトルに変換する。 4. ベクトルデータベースで、質問と意味的に近いチャンクを検索する。キーワードが一致しなくても意味が近い文書を見つけられる。 5. 検索したチャンクをプロンプトに付け加え、言語モデルが根拠付きで回答を生成する。
メリット
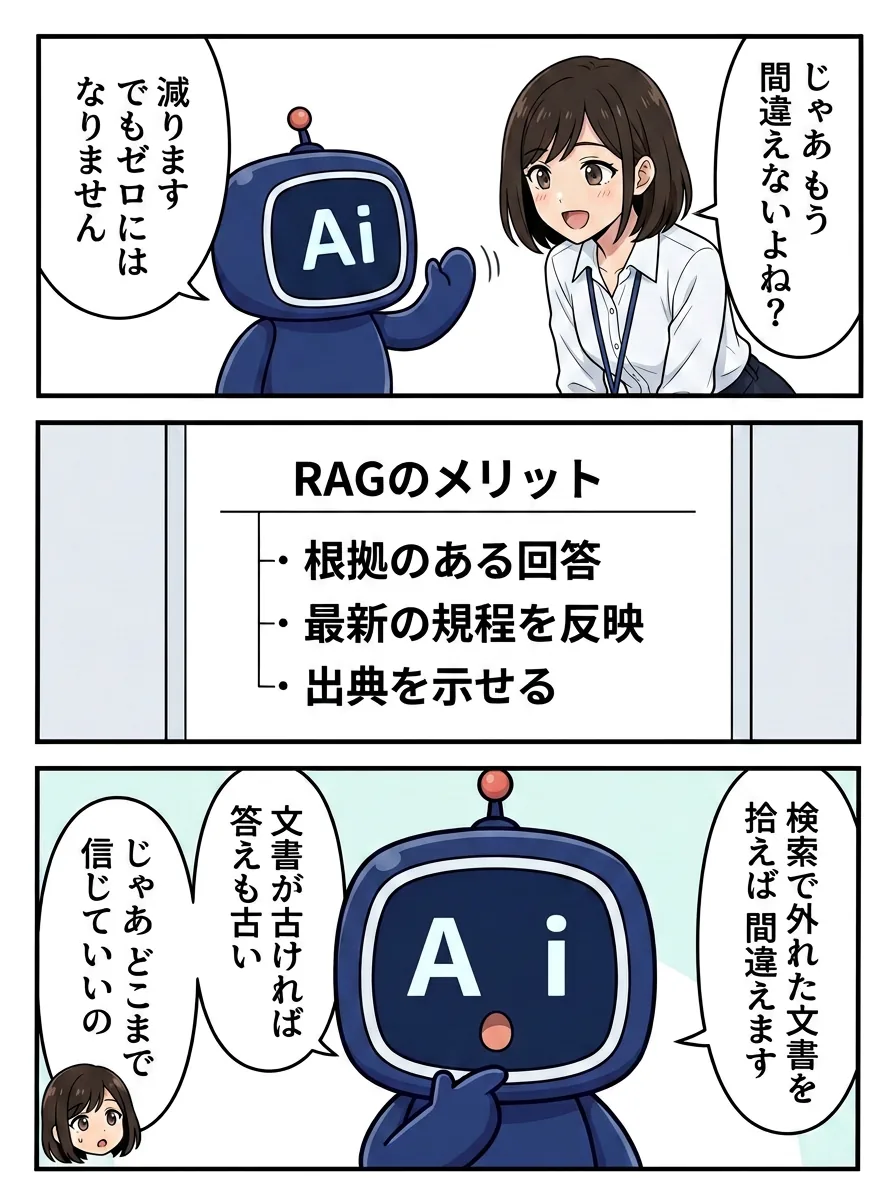
- 根拠となる文書をもとに回答するため、ハルシネーションを抑えやすい。
- モデルを再学習しなくても、文書を差し替えるだけで最新情報や社内情報を反映できる。
- 回答の出典を示せる。
ユースケース
- 社内規程やマニュアルを参照する社内ヘルプデスク・FAQ
- 製品マニュアルやサポート履歴を参照するカスタマーサポート
- 法令や社内規定を参照する法務・コンプライアンス支援
- 論文やガイドラインを参照する医療・研究支援
RAG とファインチューニングの使い分け
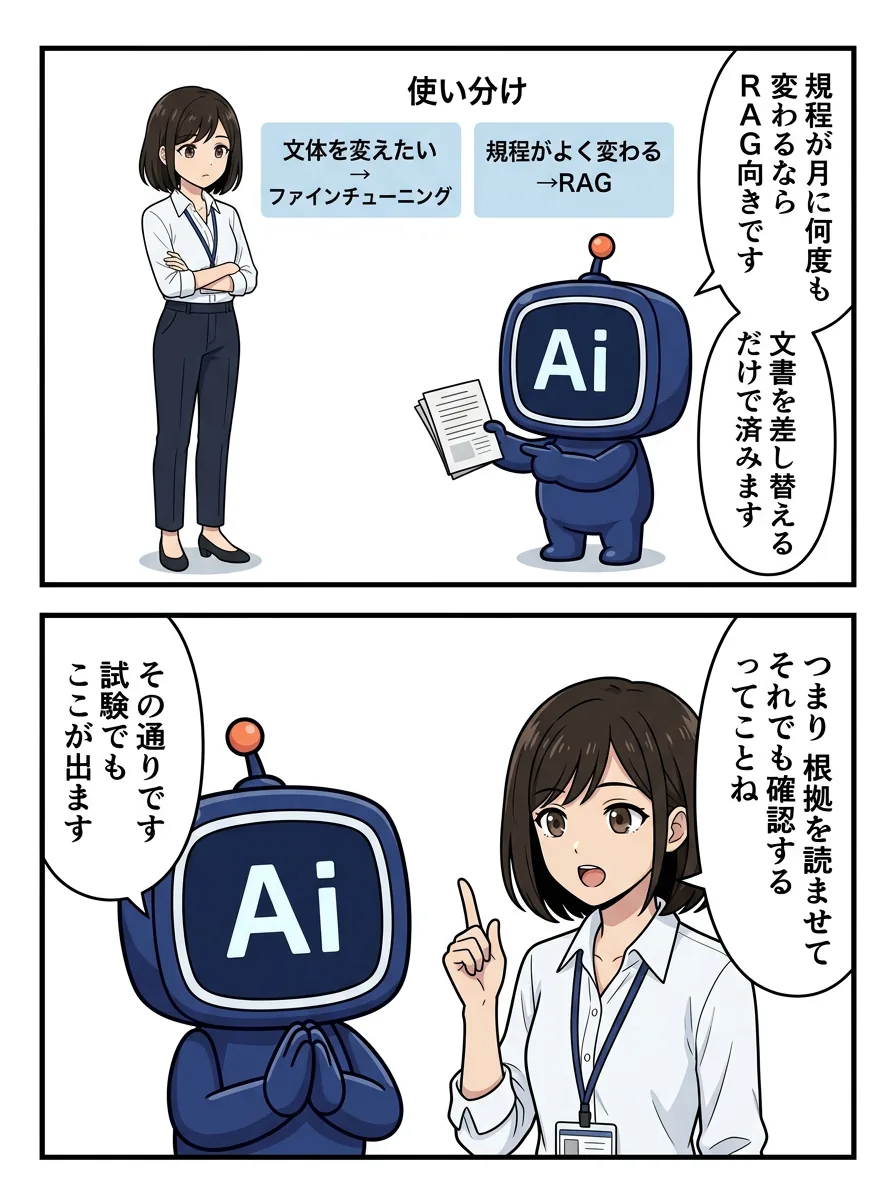
月に数回改訂される社内規程のように頻繁に更新される情報は、文書を差し替えるだけで済む RAG が向いています。ファインチューニングは改訂のたびに再学習が必要でコストがかかります。逆に、文体や応答の形式そのものを変えたい場合はファインチューニングが向いています。
限界
RAG はハルシネーションを「抑える」仕組みであり、完全になくすものではありません。検索で適切な文書が見つからなかったり、モデルが文書を誤って解釈したりすれば、誤った回答が出ます。検索対象の文書に誤りがあれば回答にも反映され、チャンクの分け方や検索精度が回答の質を左右します。人間による確認は引き続き必要です。
試験で問われる観点
- RAG の定義と「検索 → プロンプトに付加 → 生成」の流れ。
- チャンク(文書の断片)、ベクトルデータベース(意味で検索)の役割。
- メリット3つ(ハルシネーション抑制、最新・社内情報の反映、出典提示)。
- 「ハルシネーションが完全になくなる」「人間の確認が不要」は誤り。