過学習とは
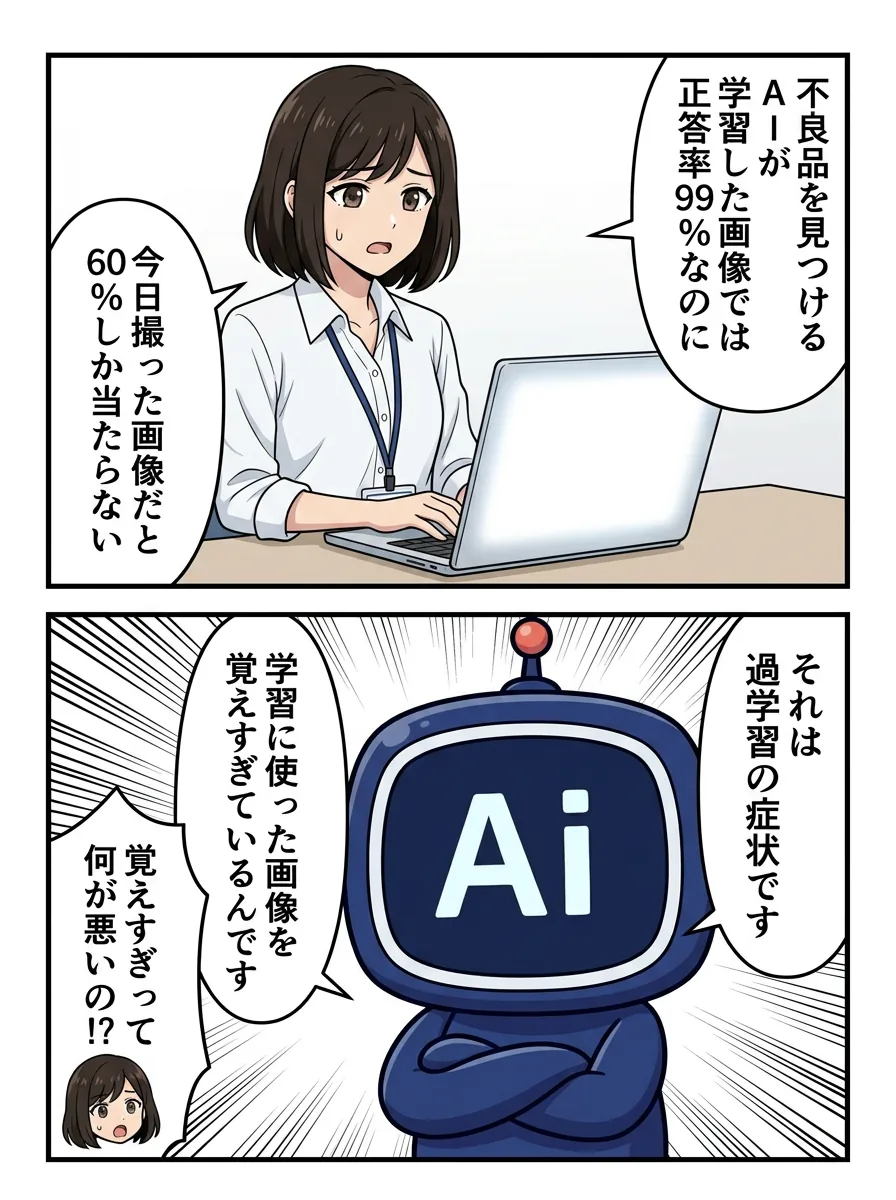
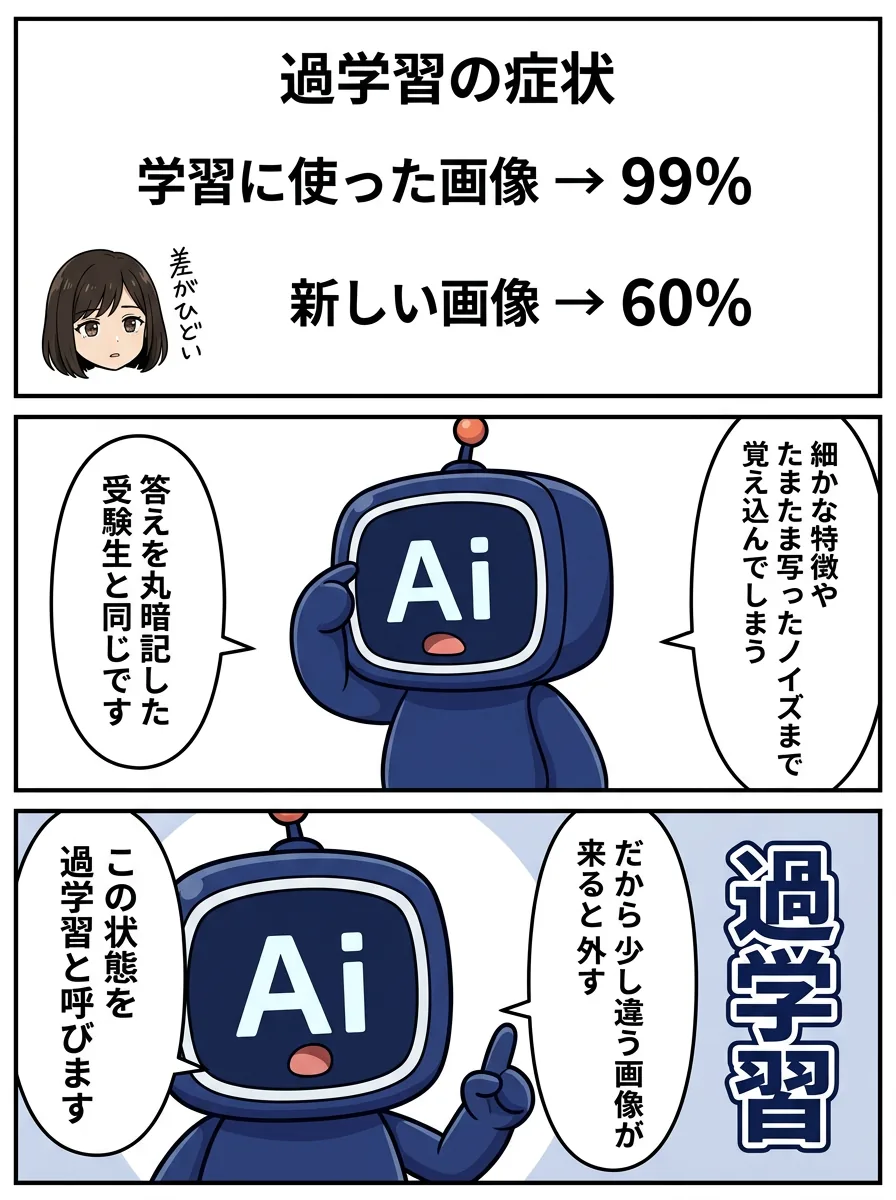
**過学習(オーバーフィッティング)**は、モデルが訓練データの細かな特徴や偶然のノイズまで覚え込んでしまい、訓練データには高い精度で対応できるのに、新しい未知のデータでは精度が大きく下がる状態です。「学習に使った画像では正答率99%、翌日撮った画像では60%」というのが典型的な症状です。
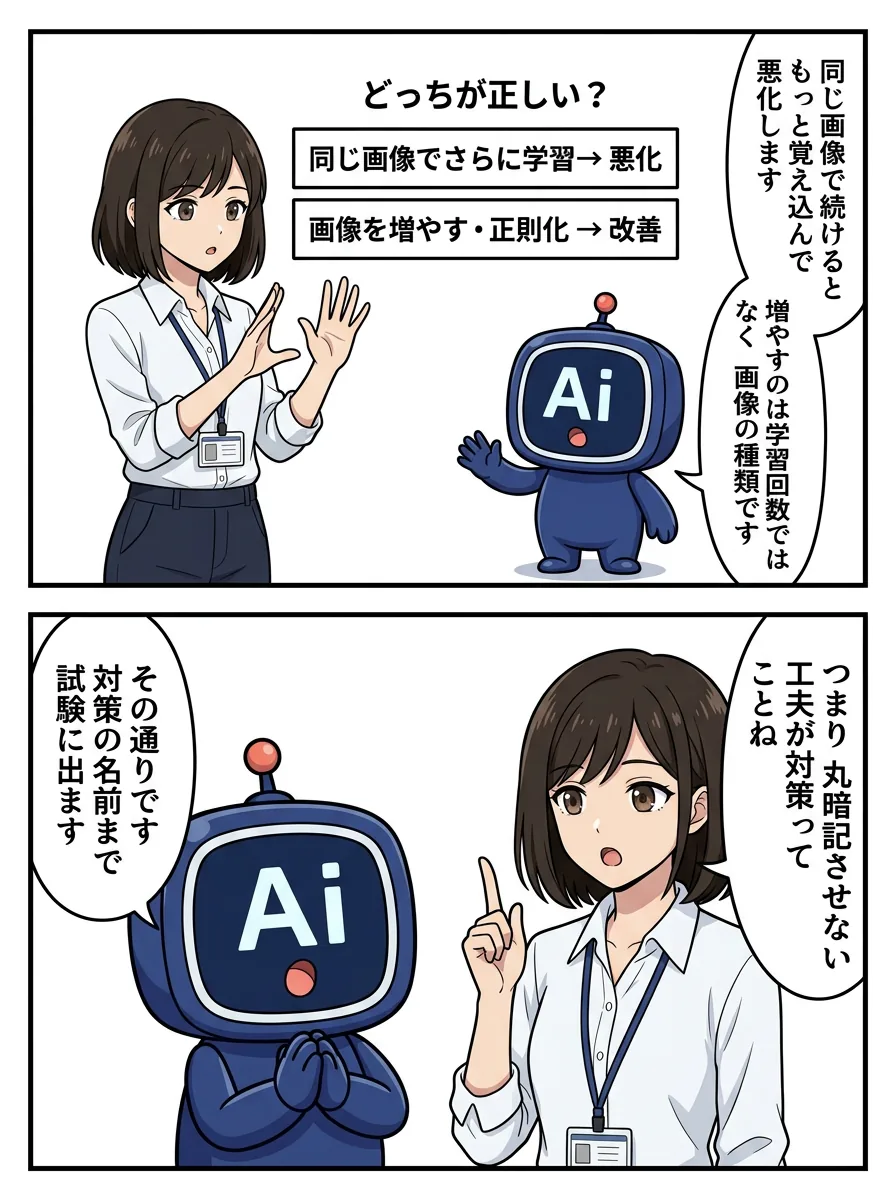
原因は、モデルが複雑すぎる、訓練データが少ない・偏っている、学習を長く続けすぎた、などです。同じデータでさらに長く学習させると、過学習はむしろ悪化します。
対策
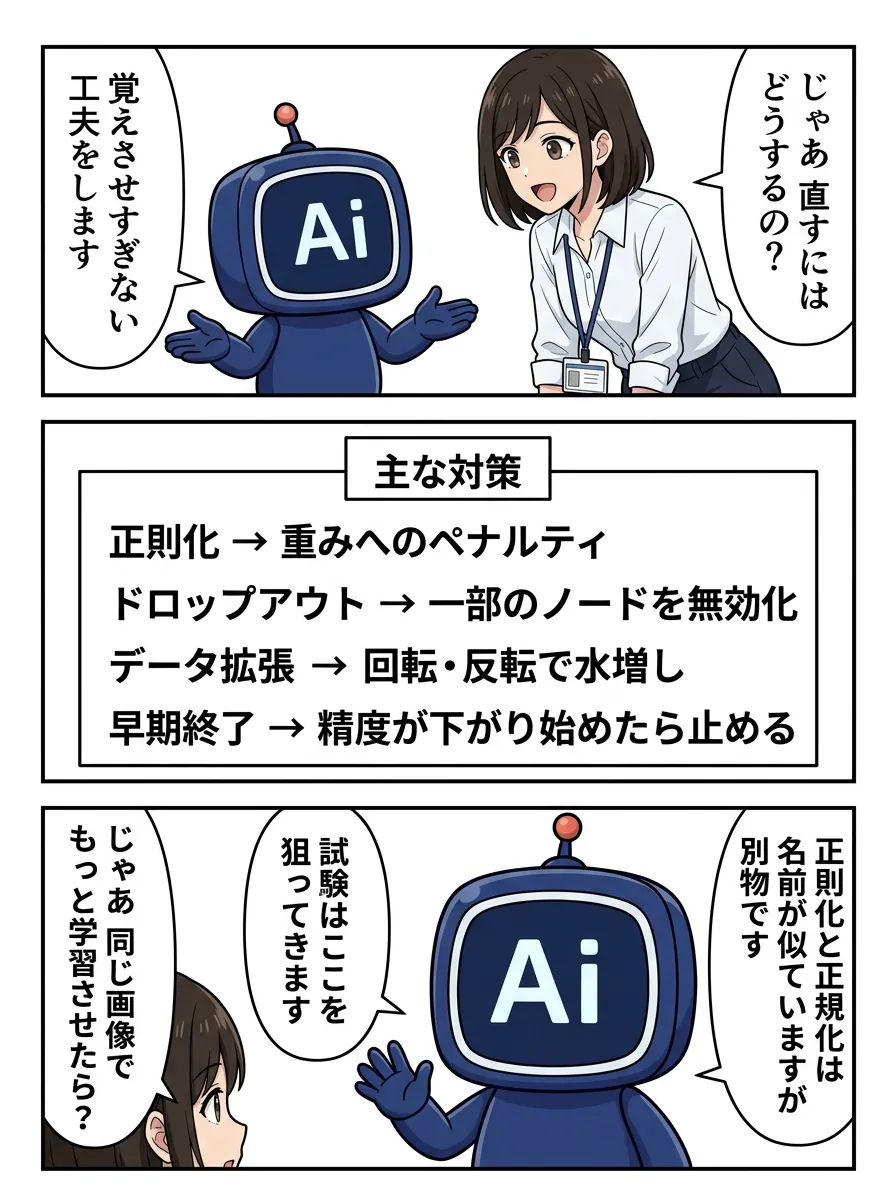
| 手法 | 内容 |
|---|---|
| 正則化 | 重みが極端に大きくなることにペナルティを与え、モデルが複雑になりすぎるのを抑える |
| ドロップアウト | 学習中に一部のノードをランダムに無効化し、特定のノードへの依存を防ぐ |
| データ拡張 | 画像の回転・反転・切り抜きなどで学習データを水増しし、多様性を持たせる |
| 早期終了 | 検証データでの精度が下がり始めた時点で学習を止める |
正則化は「正規化(データの範囲を揃える前処理)」と名前が似ていますが別物です。試験でも混同を狙った選択肢が出ます。
ドロップアウトは、毎回異なるノードの組み合わせで学習することになるため、特定のノードに頼り切る状態を避けられます。
転移学習
転移学習は、大量のデータで学習済みのモデル(例: 一般的な画像認識モデル)が獲得した知識を土台にして、別の課題(例: 自社製品の不良品検出)に比較的少ないデータで適応させる手法です。ゼロから学習するより時間もデータも節約できます。過学習の直接の対策というより、データが少ない状況でも実用的なモデルを作るための手法として覚えておきます。
ケースで考える
「不良品検出AIを作ったら、学習画像では99%、新しい画像では60%だった」という場面では、過学習を疑い、学習データを増やす、正則化やドロップアウトを適用する、が正しい対応です。「同じデータでさらに学習させる」「新しい画像の撮影をやめる」「ルールベースに切り替える」はいずれも不適切です。
試験で問われる観点
- 過学習の症状: 訓練データには強く、未知データに弱い。
- 対策の名前と内容: 正則化(重みへのペナルティ)、ドロップアウト(ノードの無効化)。
- 転移学習は学習済みモデルの流用。少ないデータで済む。