混同行列と分類の指標
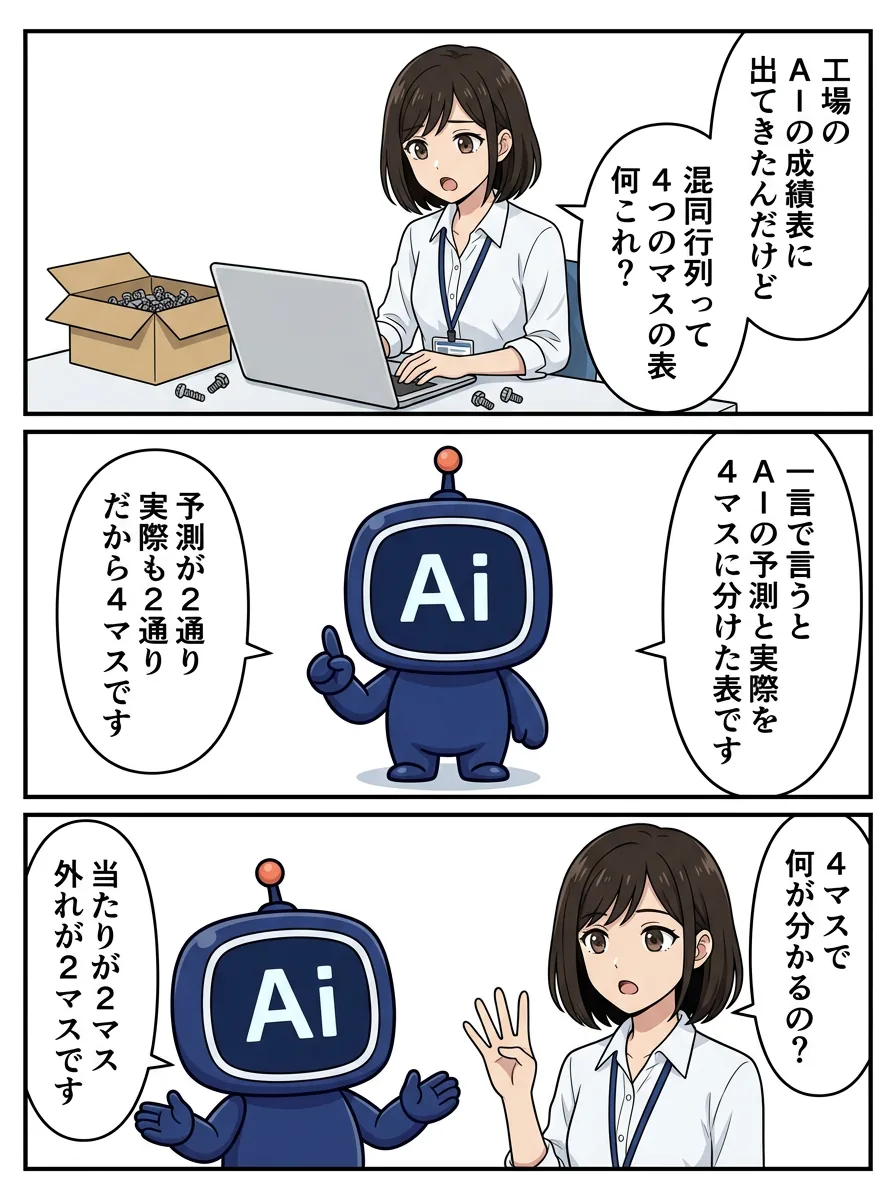
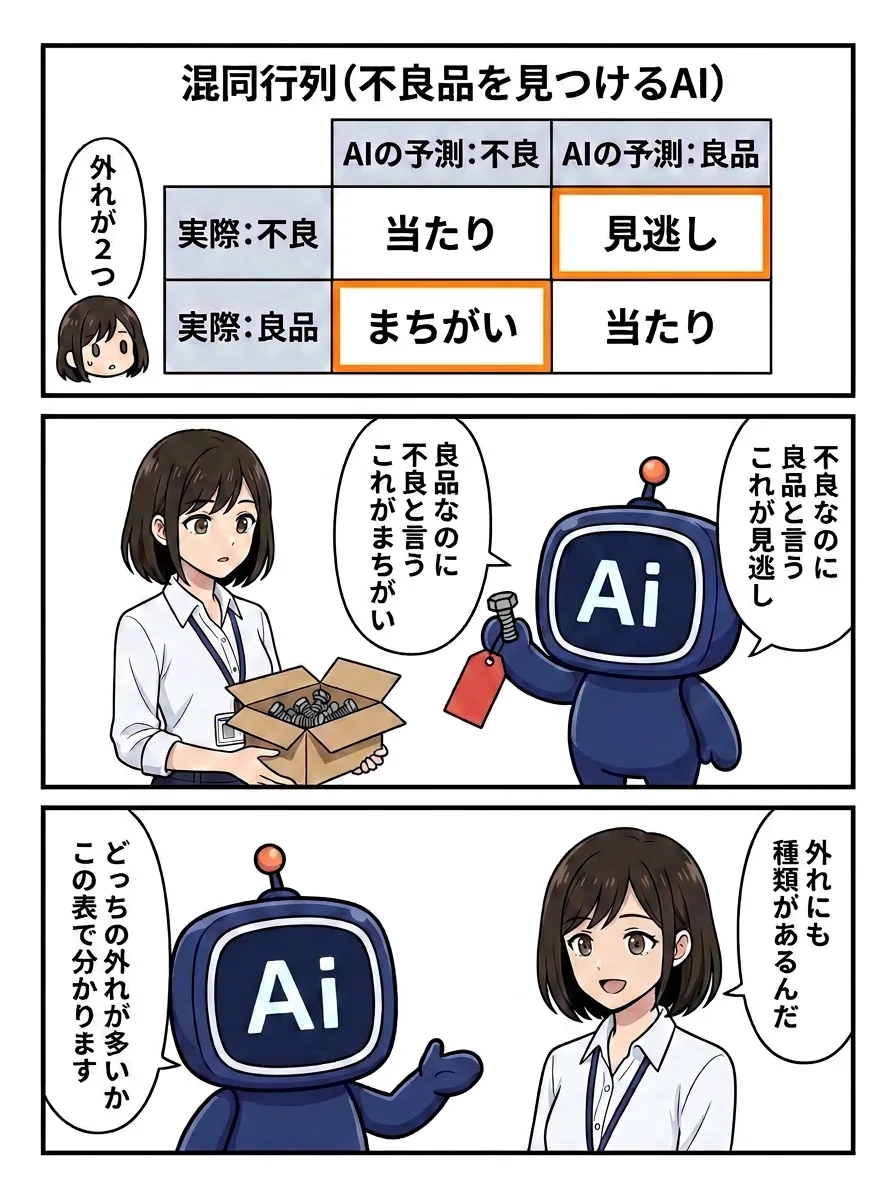
| 実際に陽性 | 実際に陰性 | |
|---|---|---|
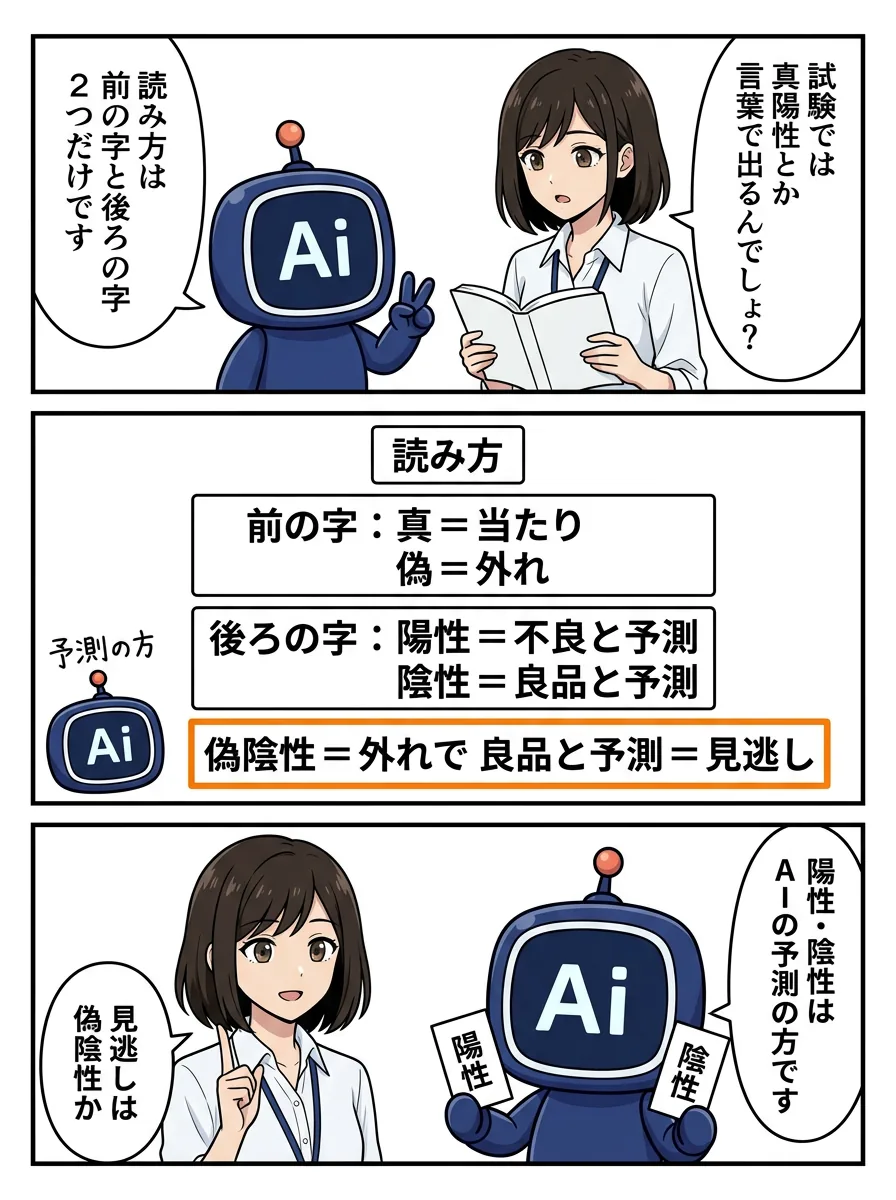
| 陽性と予測 | 真陽性 TP | 偽陽性 FP |
| 陰性と予測 | 偽陰性 FN | 真陰性 TN |
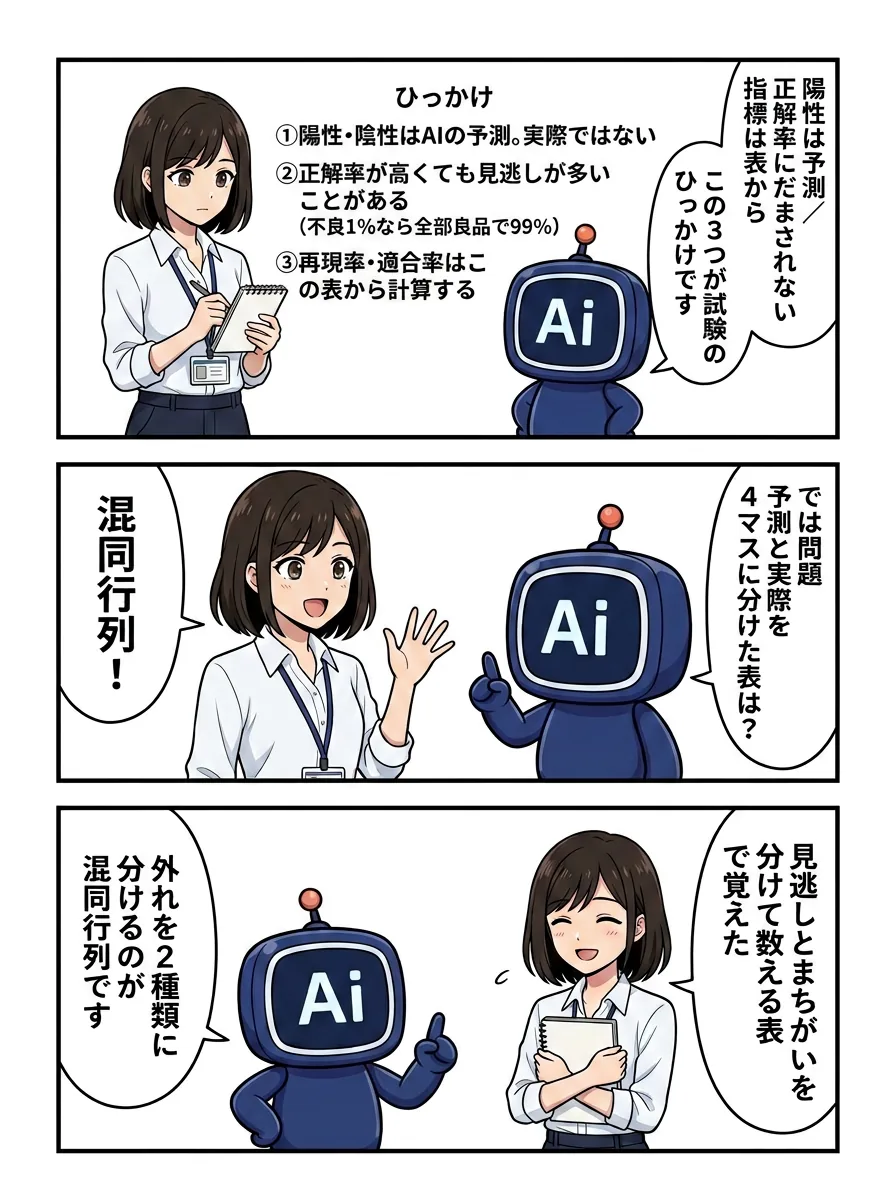
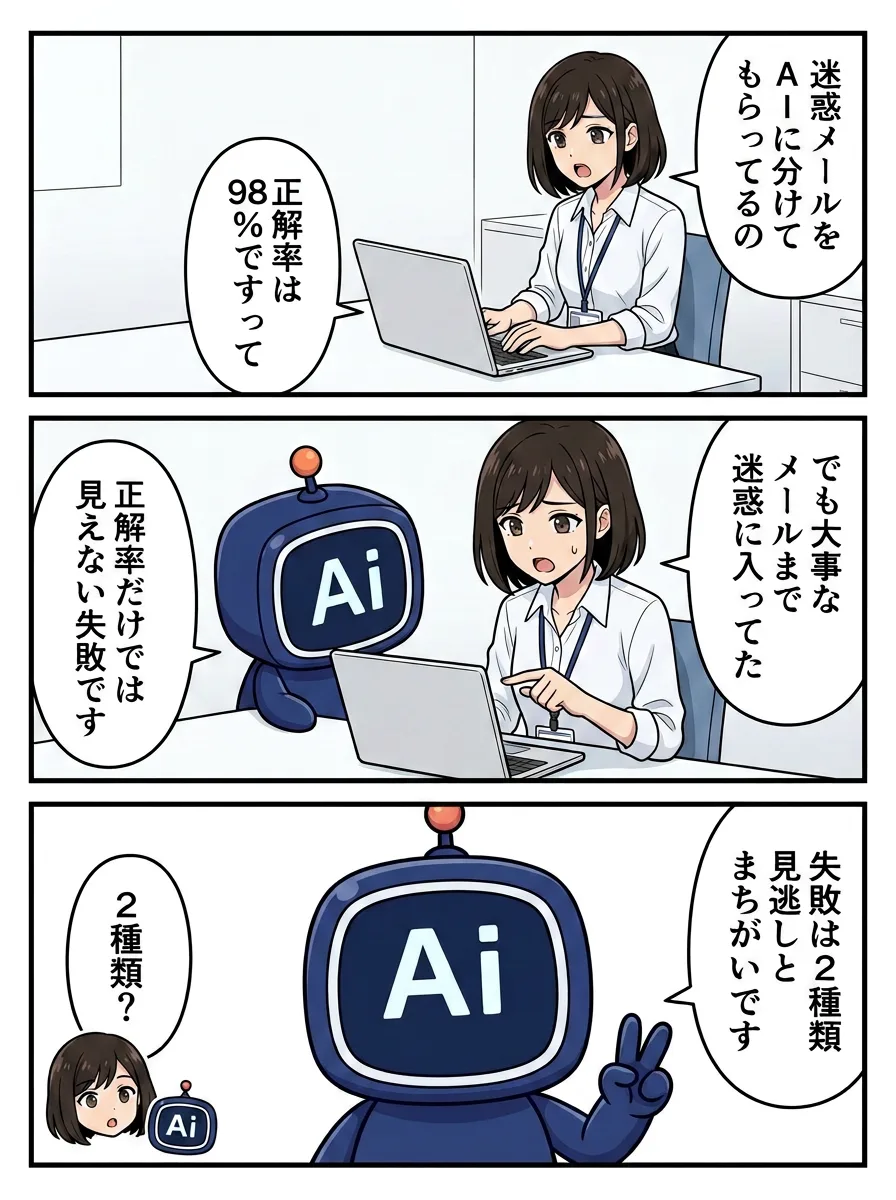
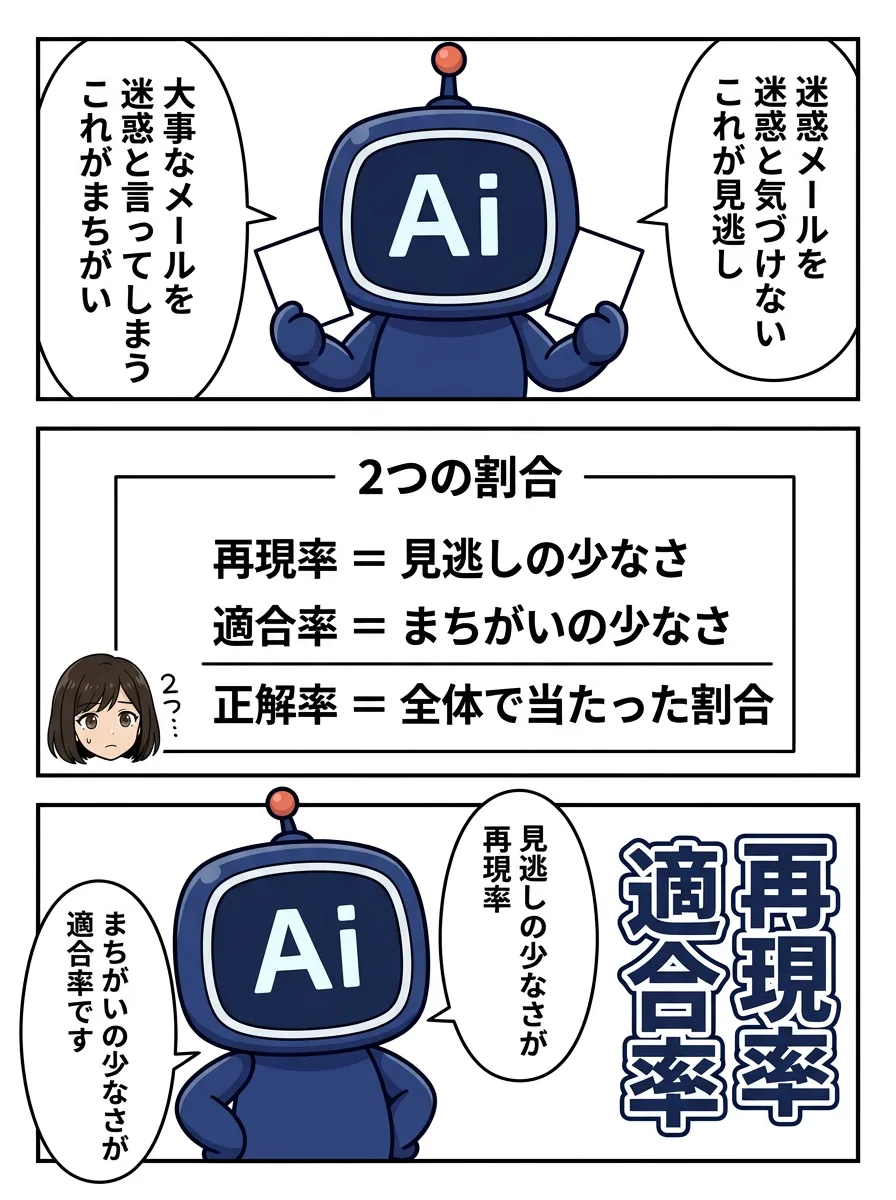
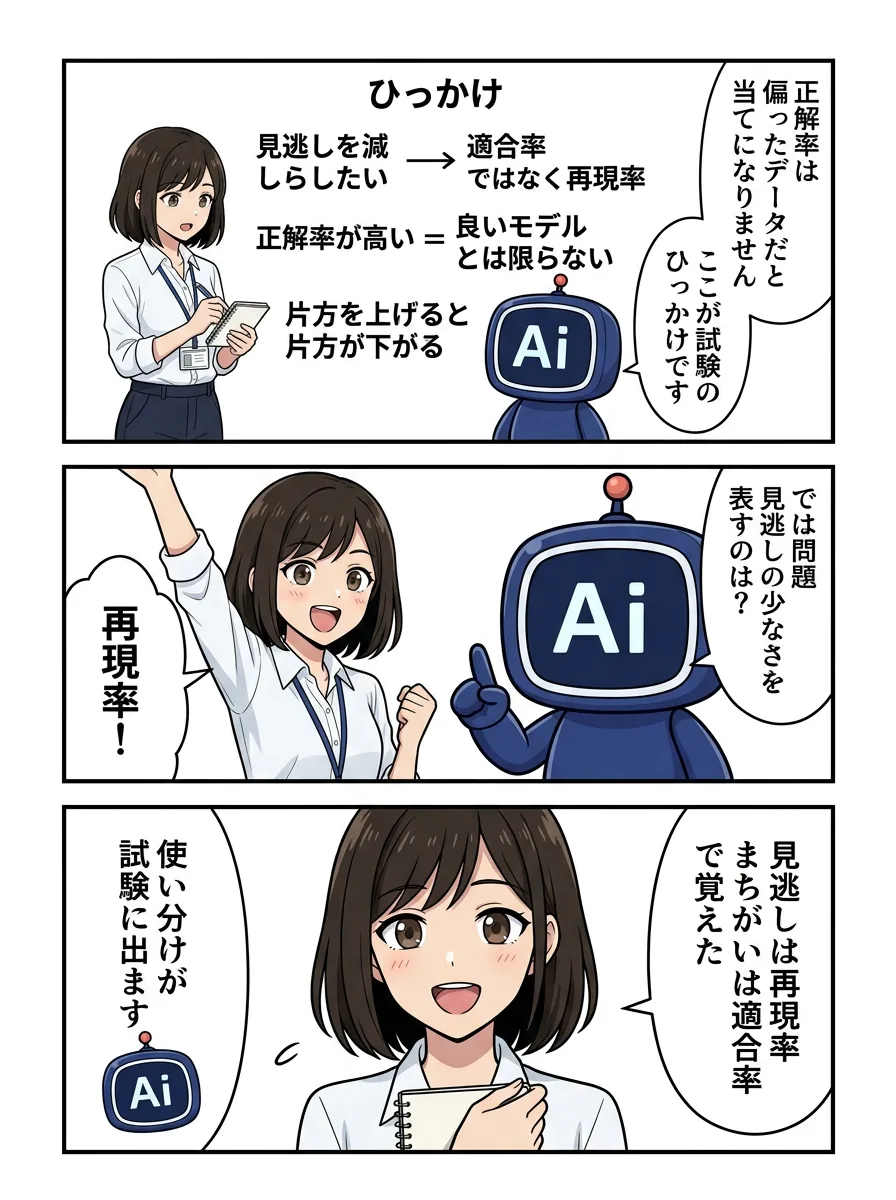
- 正解率 (TP+TN)/全体: クラスの偏りが大きいと役に立たない
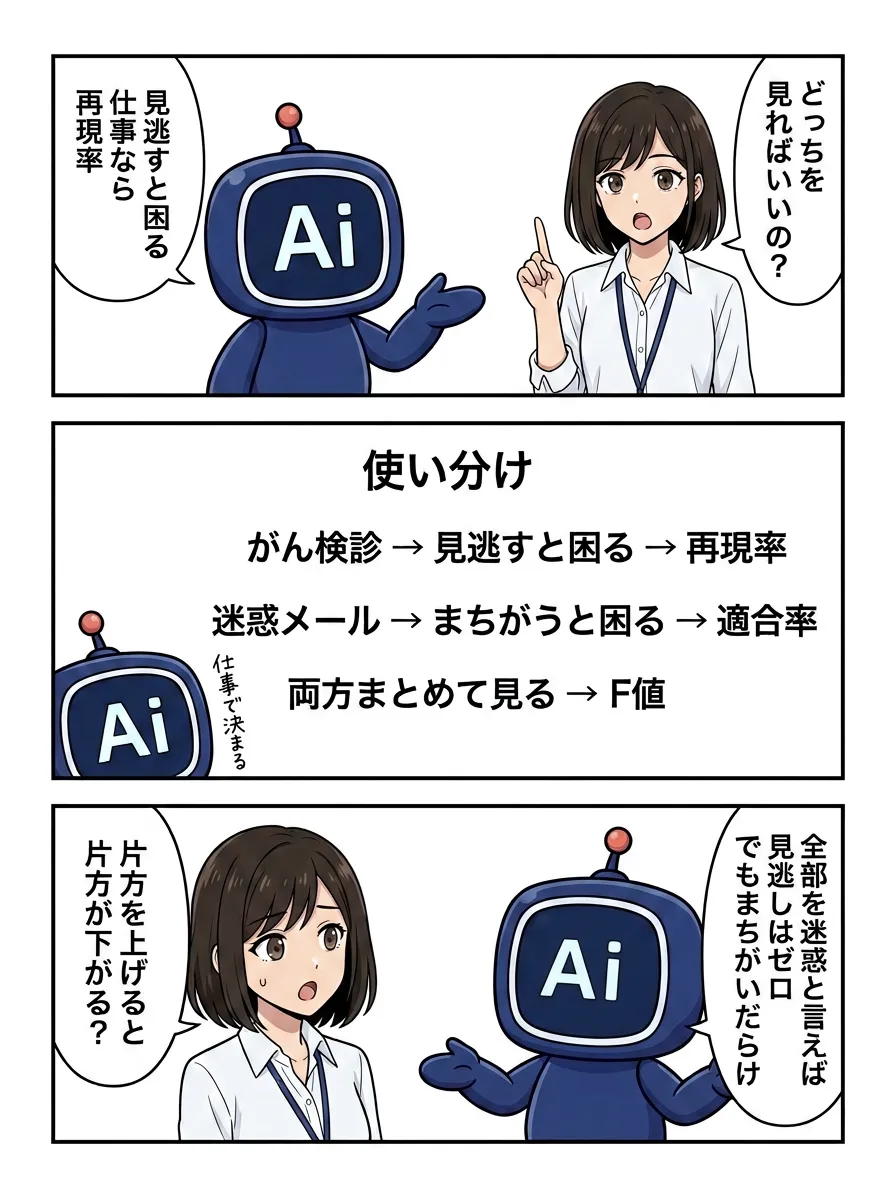
- 適合率 TP/(TP+FP): 陽性と予測したもののうち本当に陽性だった割合。誤検知を減らしたいときに重視
- 再現率 TP/(TP+FN): 実際に陽性のもののうち見つけられた割合。見逃しを減らしたいとき(がん検診)に重視
- F値: 適合率と再現率の調和平均
ROC曲線は閾値を変えながら偽陽性率(横軸)と真陽性率(縦軸)を描いた曲線で、その下の面積AUCが1に近いほど良いモデルです。
回帰の指標
MSEは誤差の二乗の平均で外れ値の影響を受けやすく、RMSEはその平方根で目的変数と同じ単位になります。MAEは誤差の絶対値の平均で、外れ値の影響が小さい指標です。いずれも小さいほど良い値です。
検証方法
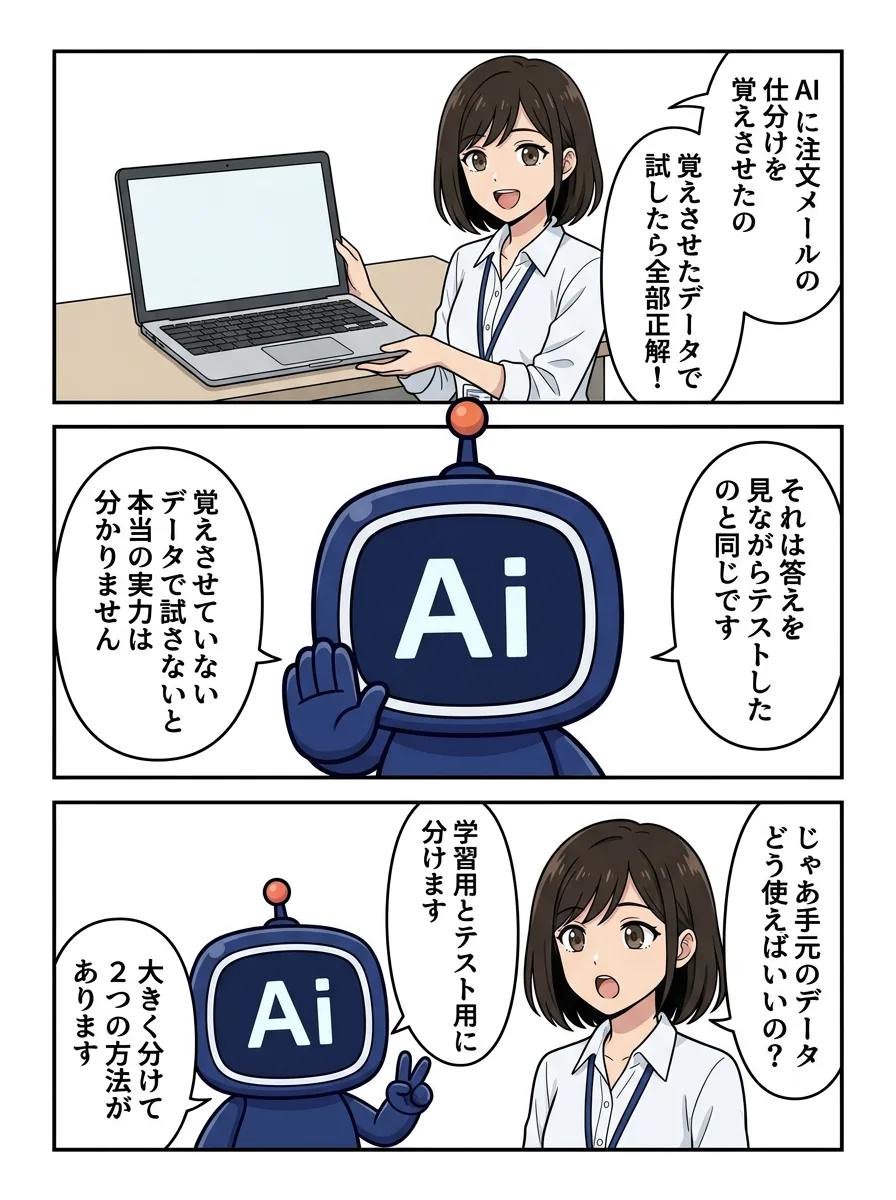
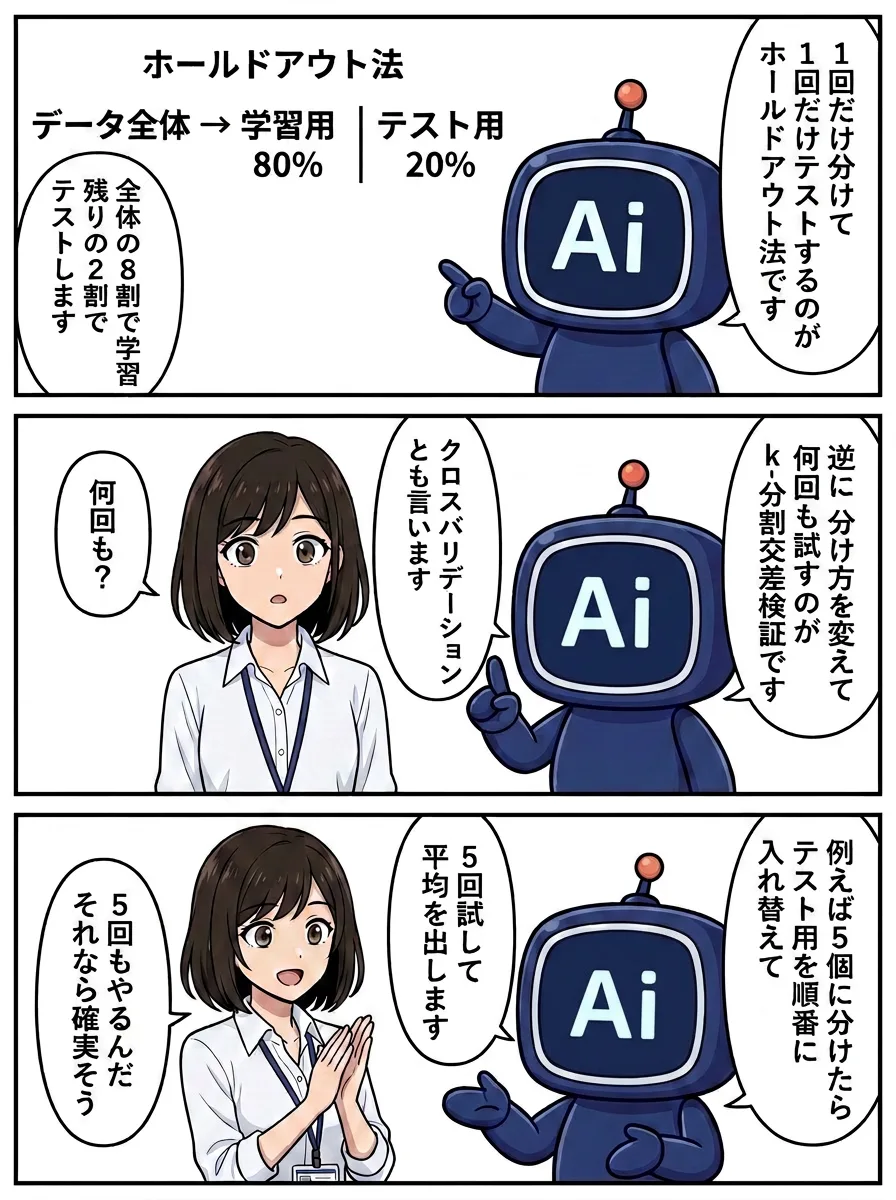
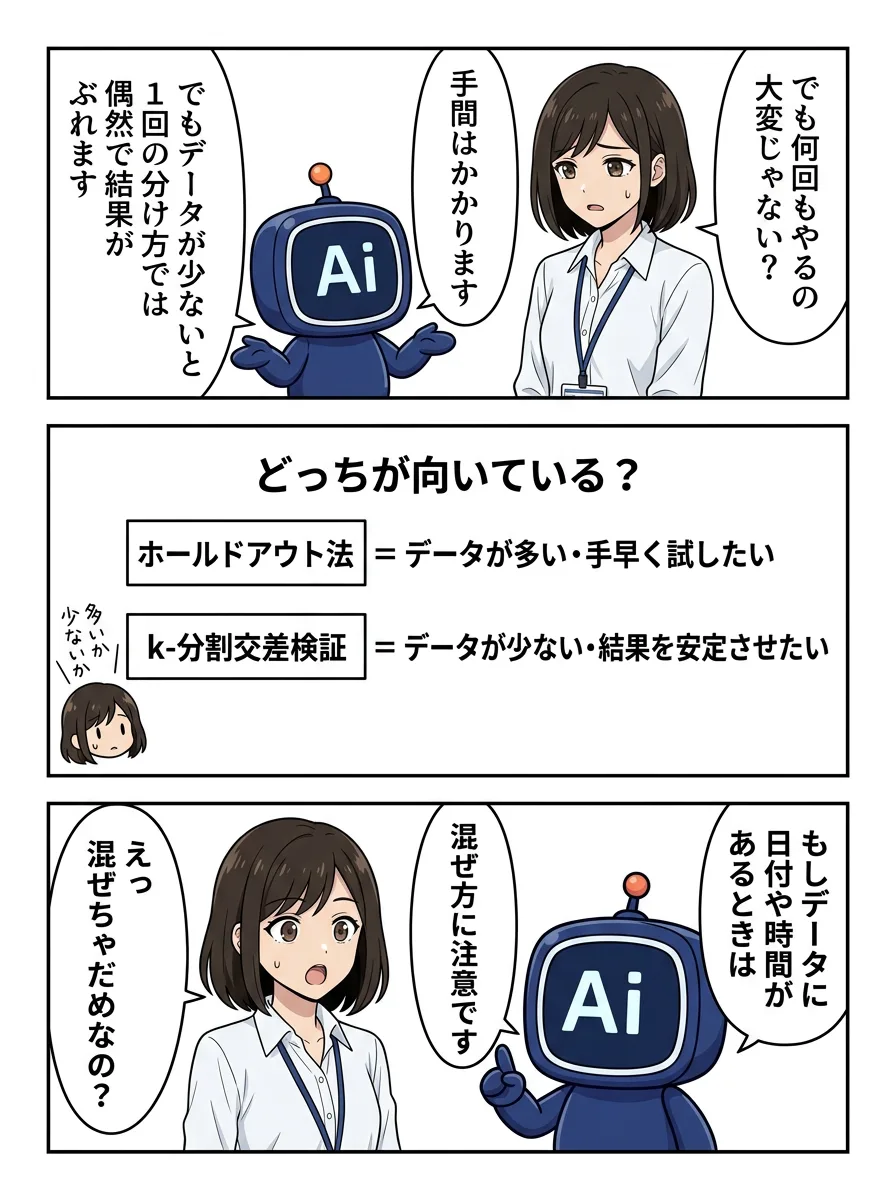
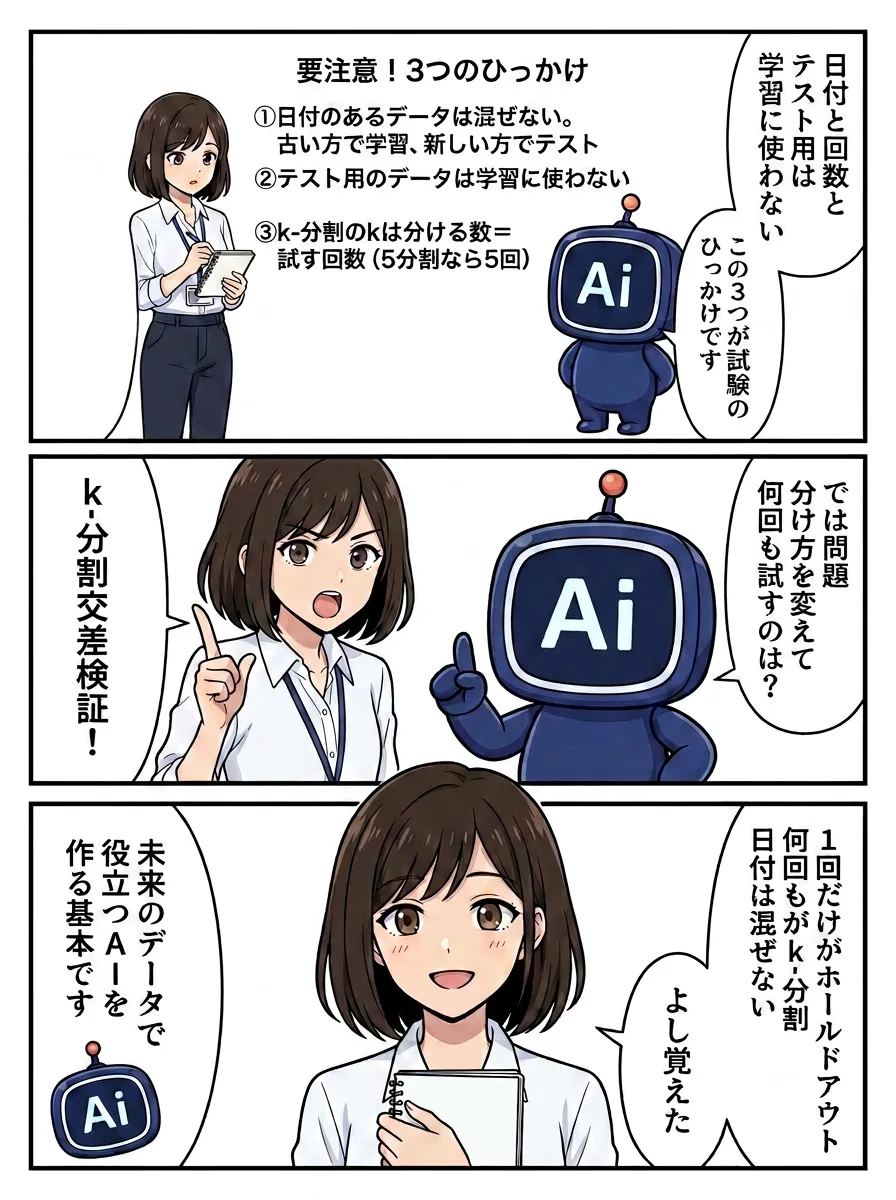
ホールドアウト検証はデータを訓練用と検証用に一度だけ分けます。k-分割交差検証はk個に分割して検証用を入れ替えながらk回評価して平均する方法で、データが少ないときに安定した推定ができます。時系列データはランダムに分けると未来の情報が漏れる(データリーケージ)ため、時間順に分割します。
過学習と汎化性能
訓練誤差は小さいのに未知データに対する汎化誤差が大きい状態が過学習です。対策はデータを増やす、正則化、モデルを単純にする、早期終了などです。逆に訓練誤差自体が大きい状態が未学習です。
モデル選択
「同じ説明力なら単純な仮説を選ぶ」というオッカムの剃刀の考えを定量化したものがAICとBICで、当てはまりの良さにパラメータ数に応じた罰則を加え、値が小さいモデルを選びます。BICはAICより罰則が強く、より単純なモデルを選びやすい傾向があります。
試験で問われる観点
- 適合率と再現率の定義と使い分け(見逃しを避けるなら再現率)
- MSE・RMSE・MAEの違い
- k-分割交差検証の手順と利点
- 過学習の対策、AIC・BICの考え方