G検定 › Web参考書 › 第3章

強化学習(マルコフ決定過程、価値関数、Q学習、方策勾配法、バンディット)

第3章 機械学習の概要 / 節 3

シラバスのキーワード: マルコフ決定過程割引率状態価値関数行動価値関数Q学習SARSA方策勾配法REINFORCEActor-Criticバンディットアルゴリズムε-greedy方策UCB方策

本文を読んだあと、覚えているか確認してください。

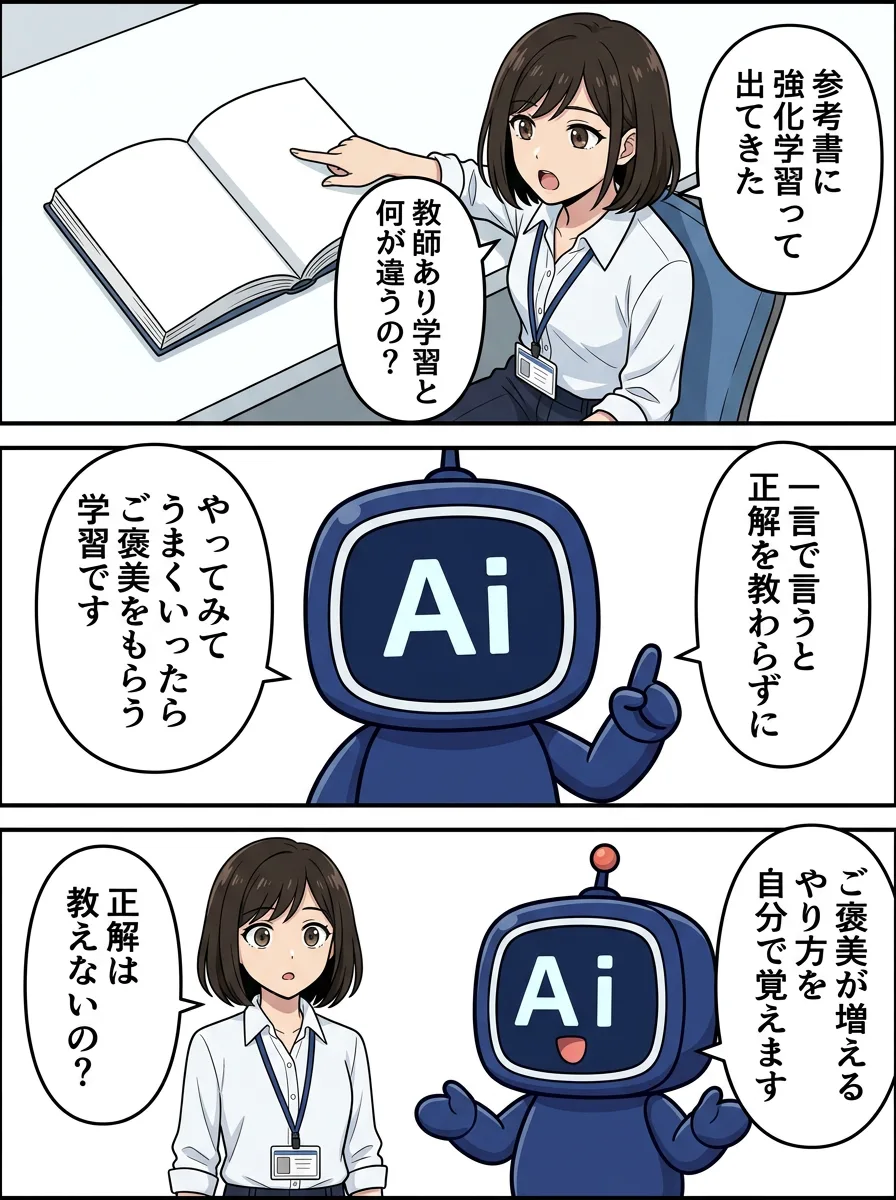
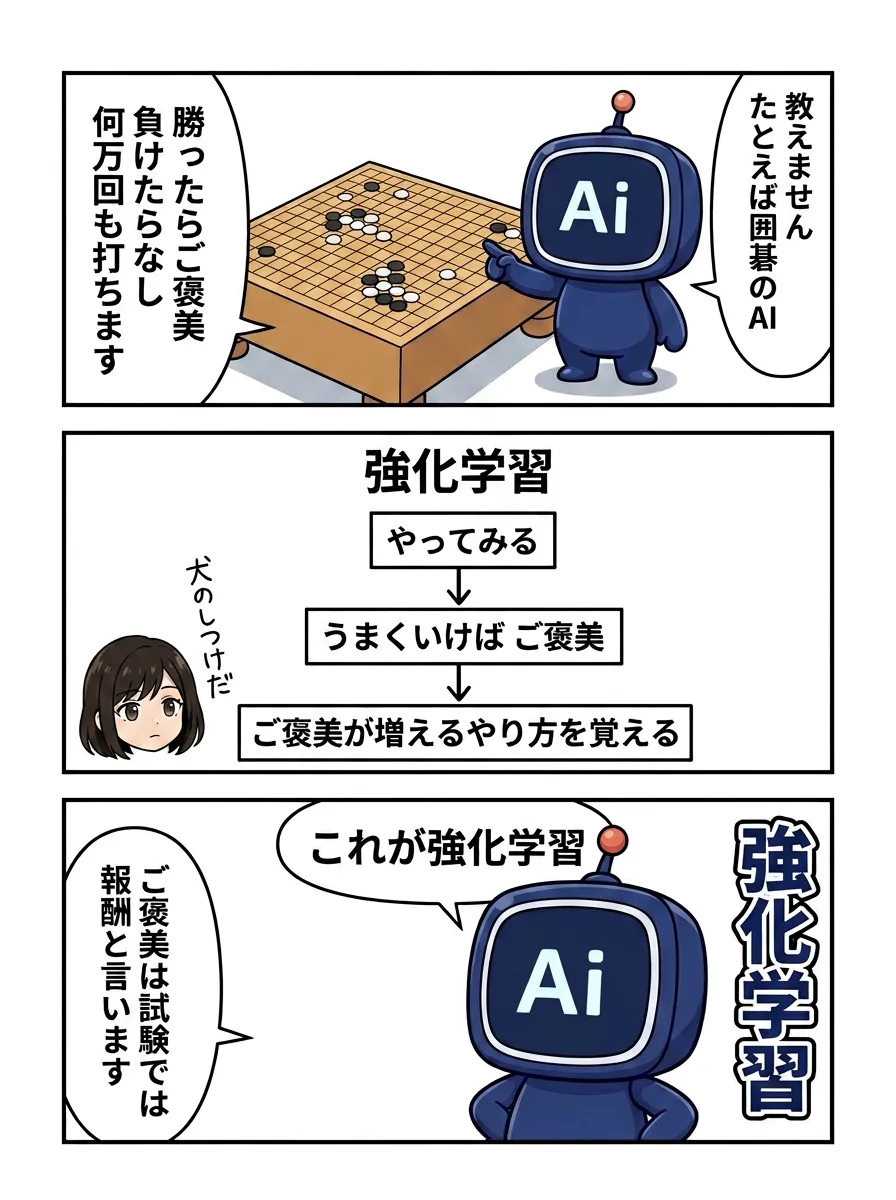
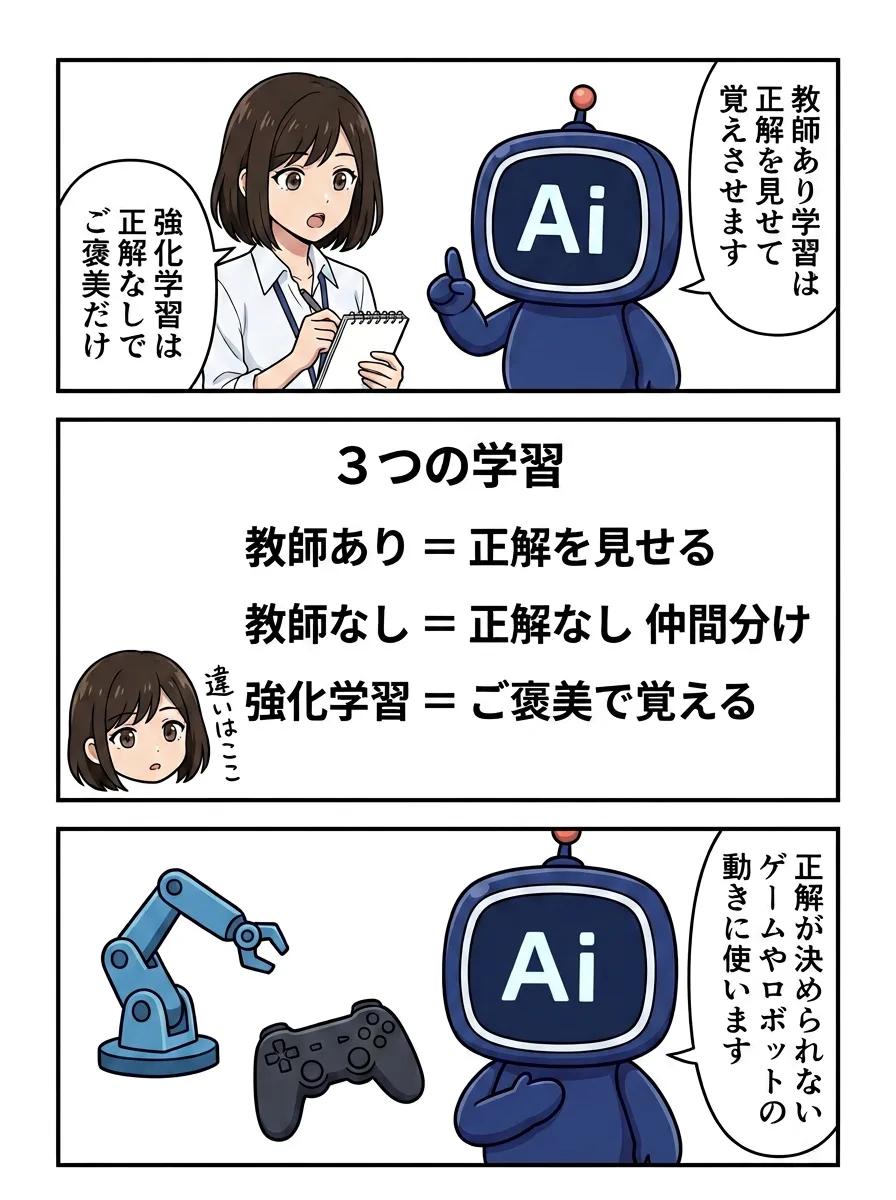
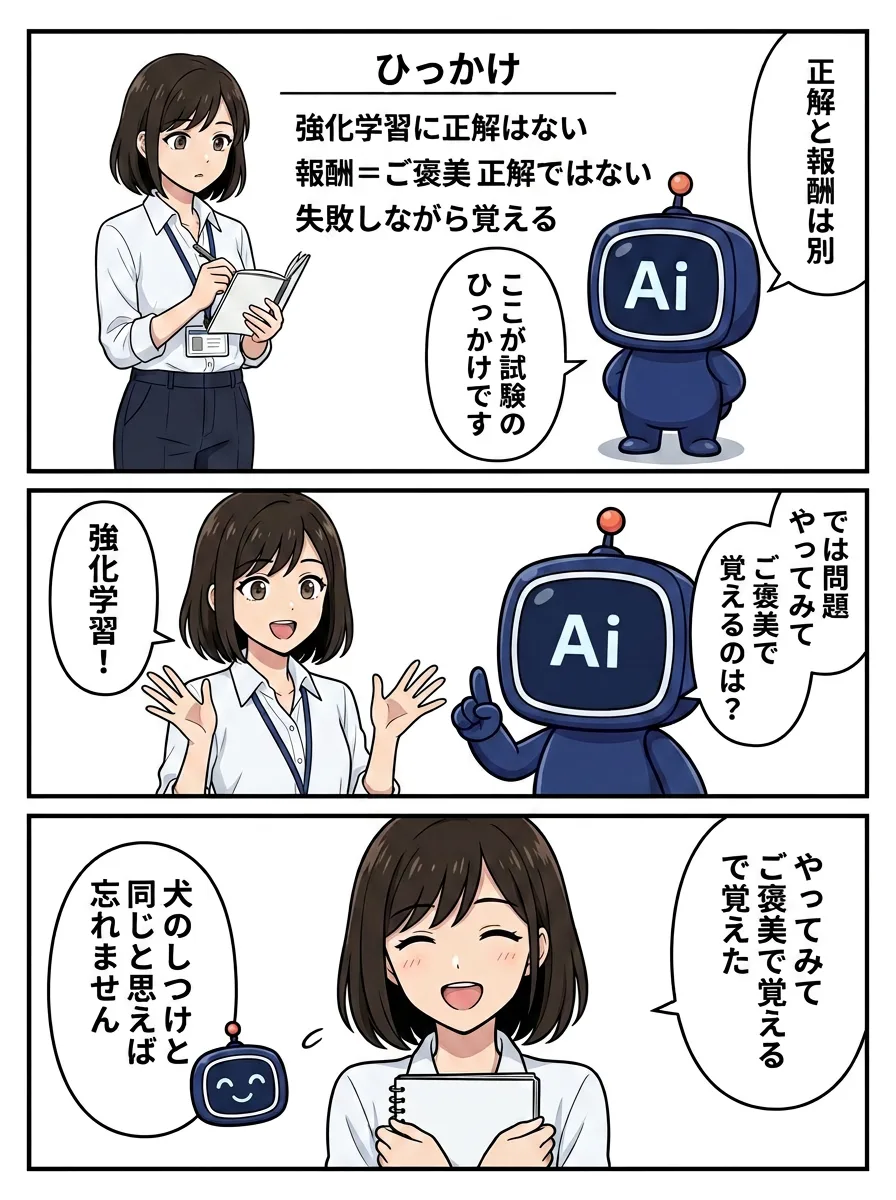
マンガで学ぶ 強化学習

Ai と みお の4ページ。上から順に読んでください。

強化学習の解説マンガ 1/4ページ強化学習の解説マンガ 2/4ページ強化学習の解説マンガ 3/4ページ強化学習の解説マンガ 4/4ページ

このマンガのページ マンガ一覧

強化学習の枠組み

エージェントが環境の状態を観測して行動を選び、その結果として報酬と次の状態を受け取ります。個々の行動に正解は与えられず、試行錯誤を通じて累積報酬を最大化する方策(状態から行動への対応)を学習する点が教師あり学習と異なります。

状態遷移が現在の状態と行動だけで決まる(過去の履歴に依存しない)という仮定をマルコフ性といい、この枠組みをマルコフ決定過程と呼びます。将来の報酬を現在の価値に換算する際に掛ける0〜1の係数が割引率で、遠い将来の報酬ほど小さく見積もります。

価値関数

2つのアプローチ

アプローチ 手法 特徴
価値関数を学習 Q学習、SARSA Q値を更新して価値の高い行動を選ぶ。Q学習は次の状態で最大のQ値を使う(方策オフ型)、SARSAは実際に取る行動のQ値を使う(方策オン型)
方策を直接学習 方策勾配法、REINFORCE 方策をパラメータで表し、報酬が増える方向に更新
両者の組み合わせ Actor-Critic 行動を決めるActorと価値を評価するCriticを別々に持つ

多腕バンディット問題

複数のスロットマシン(腕)からどれを引くかを決める問題で、強化学習の最も単純な形です。有望な腕を選ぶ「活用」と、まだ試していない腕を選ぶ「探索」のバランスが課題です。ε-greedy方策は確率εでランダムに探索し、それ以外は最も期待値の高い腕を選びます。UCB方策は試行回数の少ない腕にボーナスを加えて選びやすくします。Webのバナー選択やA/Bテストに応用されます。

試験で問われる観点

この節の練習問題(11問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    強化学習において、将来得られる報酬を現在の価値に換算する際に、遠い将来の報酬ほど小さく見積もるために掛ける0〜1の係数を( )という。括弧に入る語として最も適切なものを選びなさい。
    1. 1割引率
    2. 2学習率
    3. 3ε(イプシロン)
    4. 4マージン
    答えと解説

    正解: 1

    強化学習は状態・行動・報酬・遷移からなるマルコフ決定過程として定式化され、エージェントは将来の報酬の合計(収益)を最大化する方策を学びます。このとき遠い将来の報酬に0〜1の割引率γを累乗で掛けて割り引きます。学習率はパラメータ更新の幅、εはε-greedy方策で探索する確率、マージンはSVMの用語です。

  2. 問2
    行動価値関数Q(s, a)を学習する手法のうち、Q学習とSARSAの違いの説明として最も適切なものを選びなさい。
    1. 1Q学習は連続値の行動を扱うために行動をガウス分布で近似する手法、SARSAは離散値の行動を扱うために行動ごとにテーブルを持つ手法である
    2. 2Q学習は次の状態で価値が最大の行動を仮定して更新する方策オフ型、SARSAは実際に選んだ次の行動の価値で更新する方策オン型である
    3. 3Q学習は方策をパラメータ化して勾配で直接学習する方策ベースの手法、SARSAは状態価値関数V(s)だけを学習する価値ベースの手法である
    4. 4Q学習は実際に選んだ次の行動の価値で更新する方策オン型、SARSAは次の状態で価値が最大の行動を仮定して更新する方策オフ型である
    答えと解説

    正解: 2

    どちらも行動価値関数Qを更新して学習する手法ですが、Q学習は更新時に「次の状態で最も価値の高い行動」を用いるため、実際に行動を選ぶ方策とは独立に学べる方策オフ型(off-policy)です。SARSAは状態・行動・報酬・次の状態・次の行動(S, A, R, S', A')のうち実際に選んだ次の行動を用いるため、現在の方策に沿って学ぶ方策オン型(on-policy)です。方策を直接学習するのは方策勾配法で、どちらも強化学習であり、行動の型による専用化でもありません。

  3. 問3
    強化学習の2つの代表的なアプローチ「価値関数を学習する方法」と「方策を直接学習する方法」について、後者に該当する手法の組み合わせとして正しいものを選びなさい。
    1. 1k-means法、主成分分析
    2. 2バギング、ブースティング
    3. 3方策勾配法、REINFORCE
    4. 4Q学習、SARSA
    答えと解説

    正解: 3

    強化学習には、状態や行動の価値を推定してそこから行動を選ぶ価値ベースの手法(Q学習、SARSAなど)と、方策そのものをパラメータ化して報酬が大きくなる方向に勾配で更新する方策ベースの手法(方策勾配法、その代表例であるREINFORCE)があります。両者を組み合わせ、方策を学ぶActorと価値を評価するCriticを持つのがActor-Criticです。k-means法と主成分分析は教師なし学習、バギングとブースティングはアンサンブル学習の手法です。

  4. 問4
    複数のスロットマシンからどれを引くかを決める多腕バンディット問題において、「基本的には現時点で最も期待値の高い腕を選ぶが、一定の確率εでランダムに別の腕も試す」ことで探索と活用のバランスを取る方策として最も適切なものを選びなさい。
    1. 1ソフトマックス方策
    2. 2トンプソンサンプリング
    3. 3UCB1アルゴリズム
    4. 4ε-greedy方策
    答えと解説

    正解: 4

    バンディットアルゴリズムでは、既知の良い選択肢を使う「活用」と、まだ試していない選択肢を試す「探索」のトレードオフが問題になります。ε-greedy方策は確率1-εで最良の腕を、確率εでランダムな腕を選ぶ単純な方法です。UCB1アルゴリズムは期待値に「試行回数が少ない腕ほど大きくなる不確実性のボーナス」を加えた値が最大の腕を選ぶ方法、ソフトマックス方策は期待値に応じた確率で腕を選ぶ方法、トンプソンサンプリングは各腕の報酬分布からサンプリングして選ぶ方法で、一定確率でランダムに探索する方策とは異なります。

  5. 問5
    強化学習が教師あり学習・教師なし学習と異なる点の説明として、最も適切なものを選びなさい。
    1. 1強化学習は正解ラベルの代わりに、行動の結果として環境から得られる報酬を手がかりに、報酬の合計を最大化する行動の方針を学習する
    2. 2強化学習は正解ラベル付きのデータを大量に用意し、入力から出力への対応関係を学習する点が特徴で、報酬は正解との誤差として与えられる
    3. 3強化学習はラベルのないデータの構造や分布を学習する手法で、環境や報酬という概念は用いず、クラスタリングや次元削減と同じ枠組みに属する
    4. 4強化学習は人間があらかじめ記述した行動ルールに従って動作するもので、行動の結果から方針を更新することはなく、経験からの学習は行わない
    答えと解説

    正解: 1

    強化学習では、エージェントが環境の状態を観測して行動を選び、その結果として報酬を受け取ります。個々の行動に正解が与えられるわけではなく、試行錯誤を通じて累積報酬を最大化する方策を学ぶ点が教師あり学習と異なります。データの構造を学ぶのは教師なし学習、ルールに従うだけなのはルールベース手法です。

  6. 問6
    強化学習における「状態価値関数」と「行動価値関数」の説明の組み合わせとして正しいものを選びなさい。
    1. 1状態価値関数:ある状態で直前の行動によって得られた即時報酬の値。行動価値関数:ある状態で次に取る行動によって得られる即時報酬の値であり、将来の報酬は含まない
    2. 2状態価値関数:ある状態から方策に従って行動したときに得られる累積報酬の期待値。行動価値関数:ある状態である行動を取り、その後方策に従ったときに得られる累積報酬の期待値
    3. 3状態価値関数:方策に従ったときにある状態に遷移する確率。行動価値関数:方策に従ったときにある状態である行動を選択する確率で、報酬の大きさとは独立に定義される
    4. 4状態価値関数:ある状態である行動を取り、その後方策に従ったときに得られる累積報酬の期待値。行動価値関数:ある状態から方策に従って行動したときに得られる累積報酬の期待値
    答えと解説

    正解: 2

    状態価値関数V(s)は状態sの「良さ」を、そこから方策に従って得られる将来の累積報酬の期待値で表します。行動価値関数Q(s, a)は状態sで行動aを取ったときの累積報酬の期待値で、Q学習やSARSAはこれを学習します。行動を取る確率は方策、直前の報酬は即時報酬であり、価値関数とは異なります。

  7. 問7
    Actor-Criticの説明として、最も適切なものを選びなさい。
    1. 1行動価値関数Q(s,a)だけを学習し、各状態で価値が最大の行動を選びつつ、一定の確率εでランダムな行動を選んで探索する手法
    2. 2行動の良さを評価する価値関数(Actor)と、行動を決める方策(Critic)を別々に持ち、Actorの評価をもとにCriticの方策を更新する手法
    3. 3行動を決める方策(Actor)と、その行動の良さを評価する価値関数(Critic)を別々に持ち、Criticの評価をもとにActorの方策を更新する手法
    4. 4方策(Actor)を直接パラメータ化し、エピソード終了後に得られた収益を用いて方策勾配を計算して更新する、価値関数を持たない手法
    答えと解説

    正解: 3

    Actor-Criticは、方策を直接学習する方策勾配法の枠組みに、価値関数による評価を組み込んだ手法です。Actorが行動を出力し、Criticがその行動の価値を評価して方策の更新に使うことで、方策勾配法の学習の不安定さを抑えます。ActorとCriticの役割を入れ替えた説明は誤りです。行動価値関数だけを学習してε-greedyで探索するのはQ学習、価値関数を持たずエピソード終了後の収益で方策勾配を計算するのはREINFORCEの考え方です。

  8. 問8
    Webサイトの担当者が、複数のバナー広告のうちどれを表示するかを、クリック率を最大化するように自動で決めたい。各バナーの真のクリック率は事前には分からず、表示して反応を見ながら決める必要がある。この課題に最も適した考え方を選びなさい。
    1. 1主成分分析の次元削減問題として扱い、バナー画像を少数の主成分に圧縮し、第1主成分の値が最も大きいバナーを表示し続ける
    2. 2k-means法のクラスタリング問題として扱い、バナーを画像の特徴で分類し、最も大きいクラスタに属するバナーを表示する
    3. 3線形回帰の問題として扱い、バナーの画像サイズや色数からクリック率を予測し、予測値が最大のバナーだけを表示し続ける
    4. 4多腕バンディット問題として扱い、クリック率が高そうなバナーの活用と、まだ試していないバナーの探索のバランスを取る
    答えと解説

    正解: 4

    どのバナーが良いか分からない中で、表示(行動)と反応(報酬)を繰り返して最良の選択肢を見つける課題は、強化学習の最も単純な形である多腕バンディット問題です。ε-greedy方策やUCB方策で、有望な選択肢の活用と未知の選択肢の探索を両立させます。次元削減、クラスタリング、サイズからの回帰はこの課題の構造に合いません。

  9. 問9
    強化学習で学習させたエージェントが、遠い将来の報酬を重視しすぎて目先の報酬を取り逃している。目先の報酬を重視させたいときの調整として最も適切なものを選びなさい。
    1. 1割引率を1に近い大きな値にする
    2. 2割引率を0に近い小さな値にする
    3. 3ε-greedy方策のεを大きくする
    4. 4行動価値関数を状態価値関数に替える
    答えと解説

    正解: 2

    割引率は将来の報酬を現在の価値に換算する0〜1の係数で、小さくするほど遠い将来の報酬が小さく見積もられ、目先の報酬を重視するようになります。1に近づけると逆に将来の報酬を重視します。εを大きくするとランダムな探索が増えるだけで、価値関数の種類を替えても報酬の重み付けは変わりません。

  10. 問10
    強化学習に関する記述として、不適切なものを選びなさい。
    1. 1マルコフ性は、次の状態が現在の状態と行動だけで決まるという仮定である
    2. 2Q学習は、次の状態で最大のQ値を使って更新する方策オフ型の手法である
    3. 3UCB方策は、試行回数の多い腕ほどボーナスを加えて選びやすくする
    4. 4方策勾配法は、方策をパラメータで表し報酬が増える方向に更新する
    答えと解説

    正解: 3

    UCB方策がボーナスを加えるのは試行回数の少ない腕で、まだ十分に試していない腕を選びやすくして探索を促します。マルコフ性の定義、Q学習が方策オフ型であること、方策勾配法の更新の考え方はいずれも正しい記述です。

  11. 問11
    強化学習において、エージェントがある状態でどの行動を取るかを定めた、状態から行動への対応を何というか。最も適切なものを選びなさい。
    1. 1報酬
    2. 2割引率
    3. 3方策
    4. 4状態価値関数
    答えと解説

    正解: 3

    状態から行動への対応を方策といい、強化学習は累積報酬が最大になる方策を試行錯誤で学習します。報酬は行動の結果として環境から受け取る値、割引率は将来の報酬を現在の価値に換算する0〜1の係数、状態価値関数は状態から方策に従って行動したときの累積報酬の期待値です。