生成AIパスポート › Web参考書 › 第1章

AIに知能をもたらす仕組み:ルールベースと機械学習

第1章 AI(人工知能) / 節 2

シラバスのキーワード: ルールベース機械学習学習済みモデル教師あり学習教師なし学習クラスタリング次元削減強化学習半教師あり学習ノーフリーランチ定理

本文を読んだあと、覚えているか確認してください。

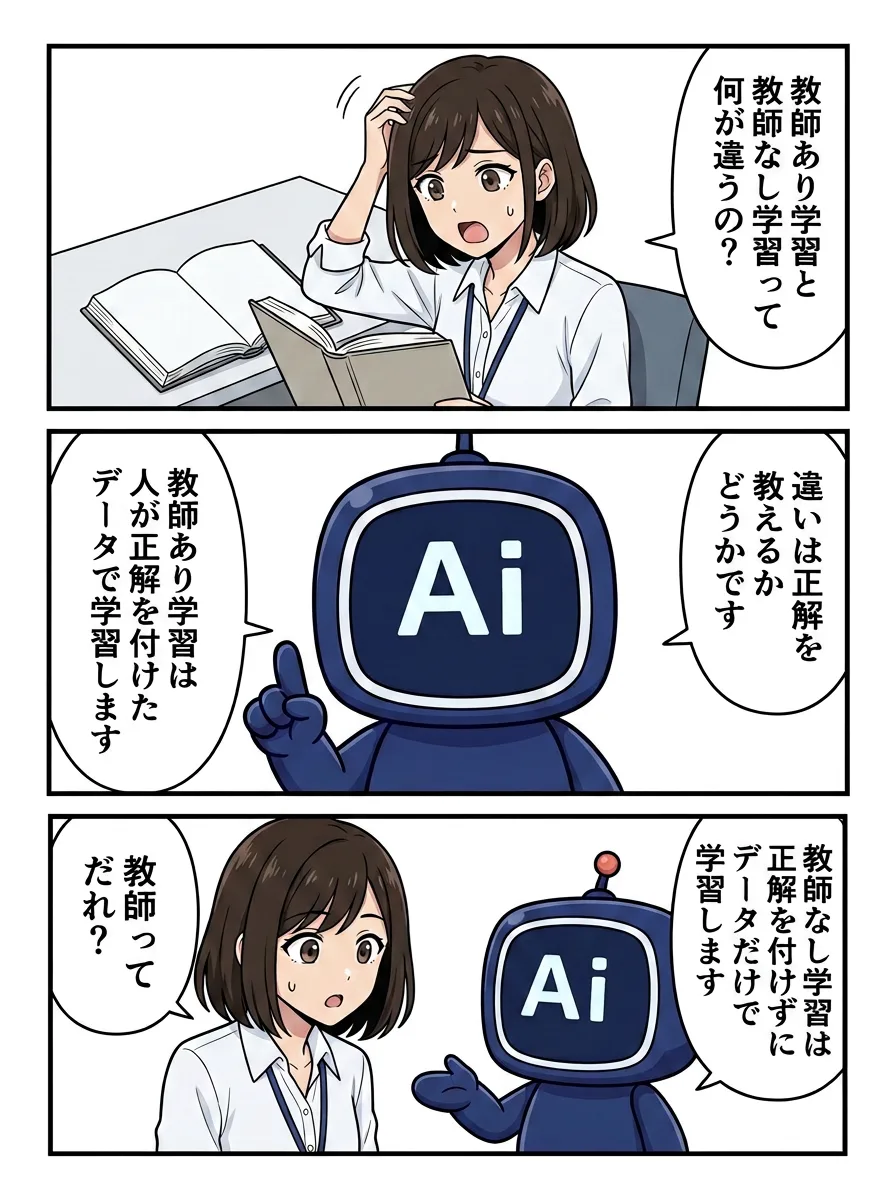
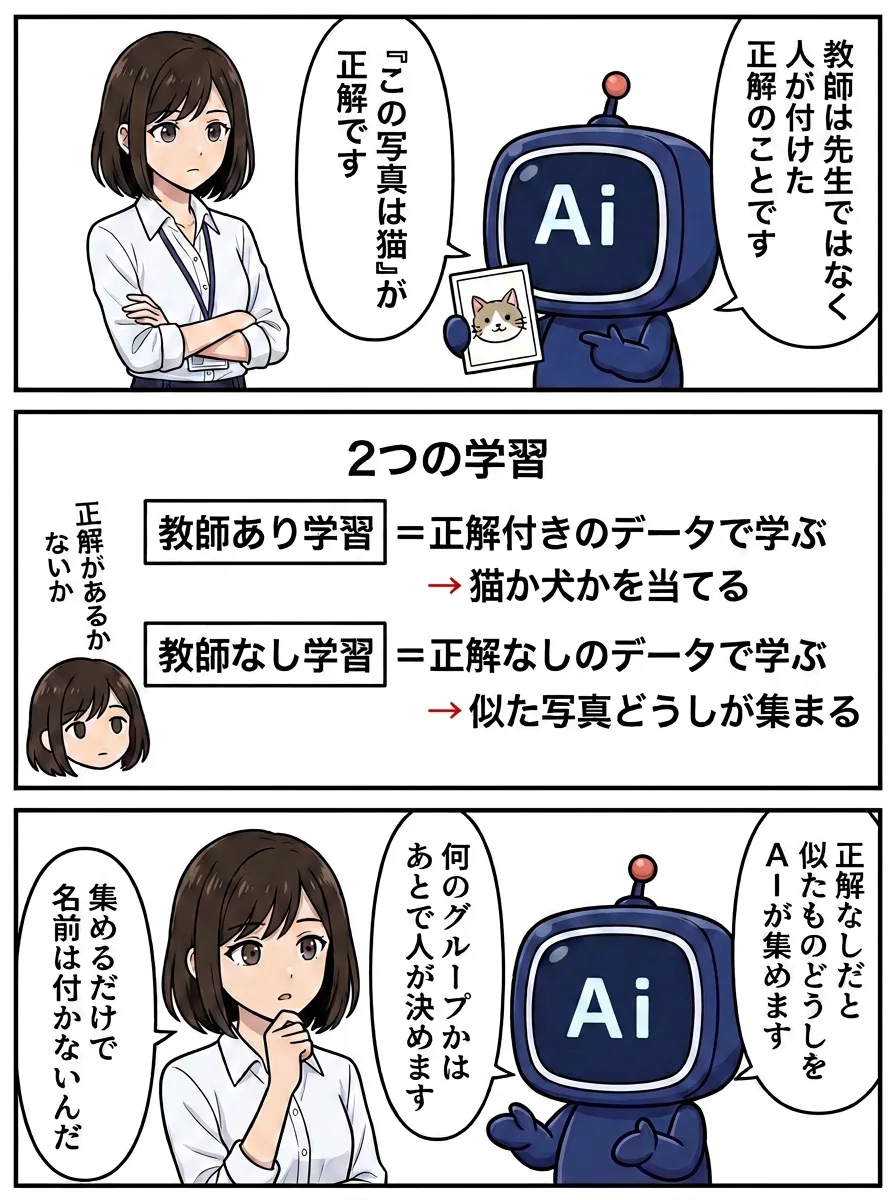
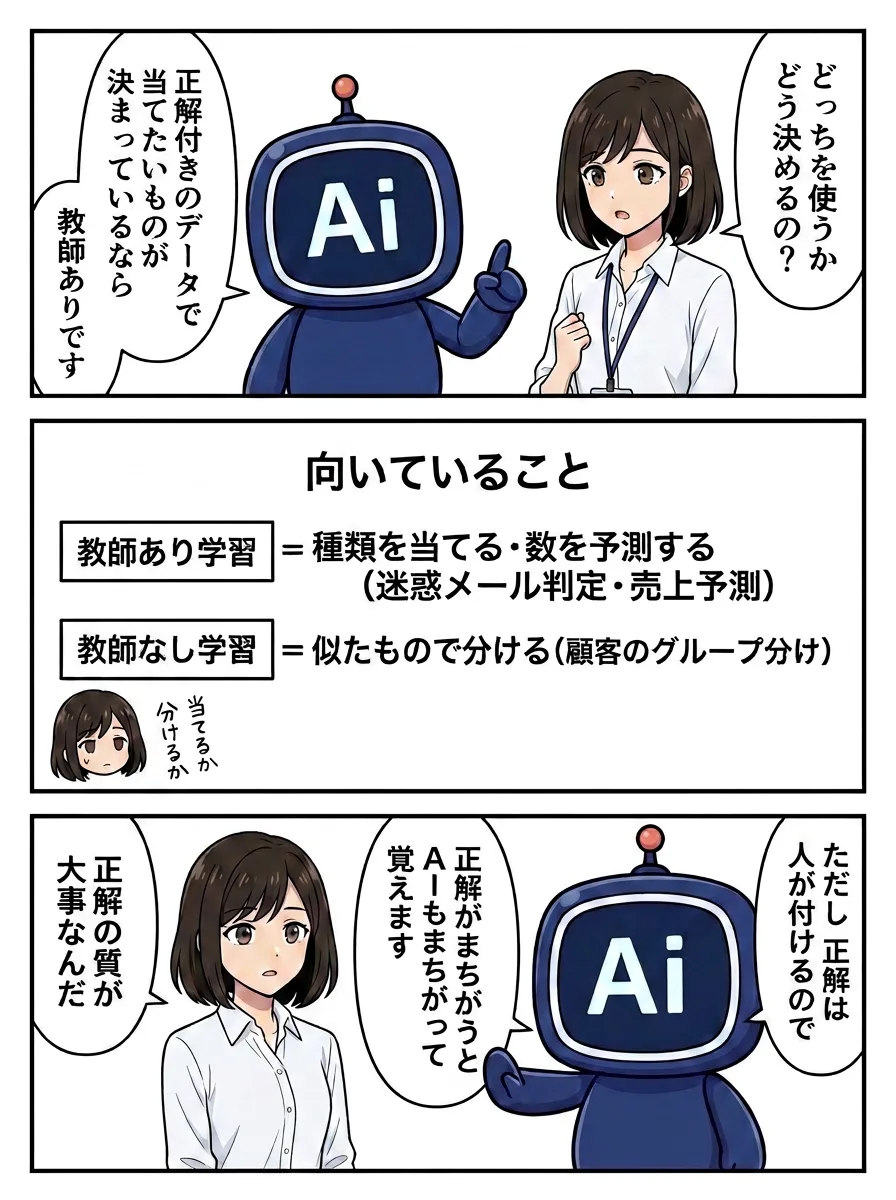
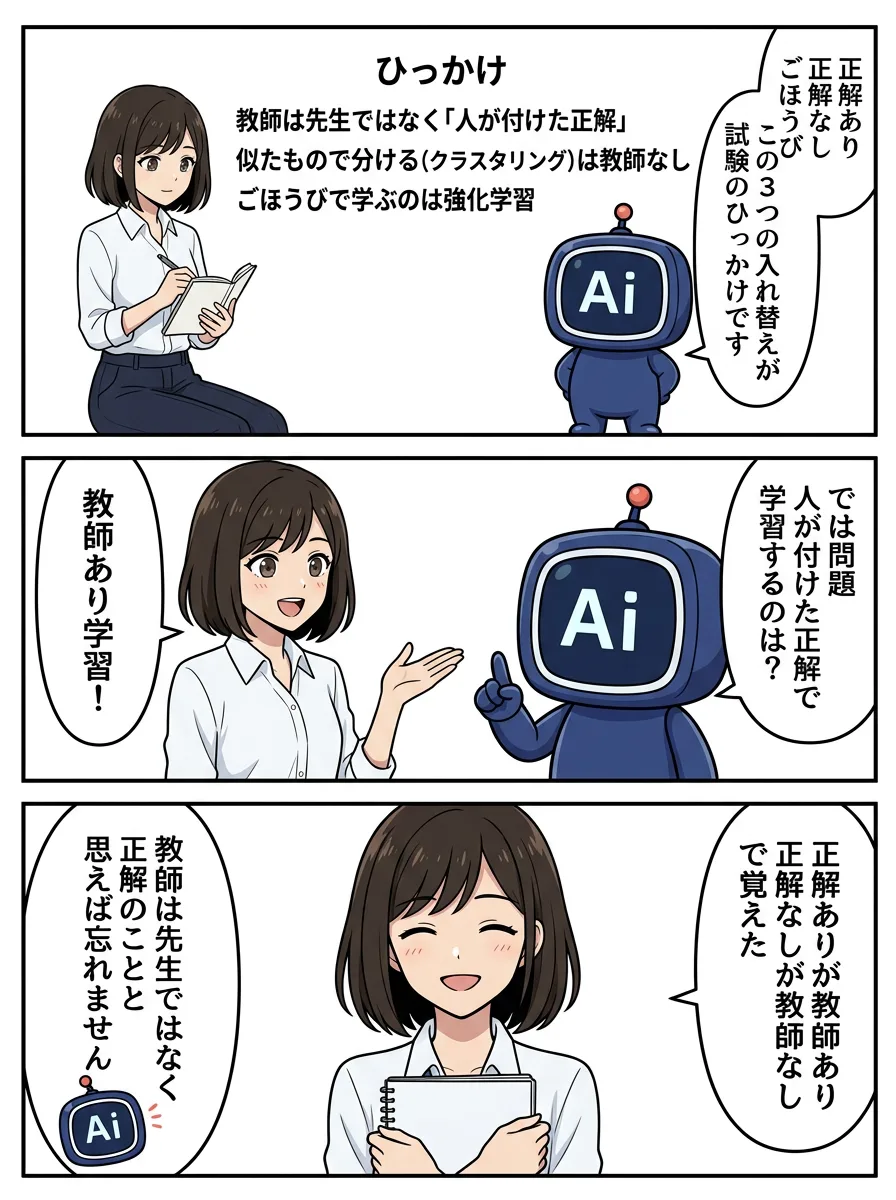
マンガで学ぶ 教師あり学習・教師なし学習

Ai と みお の4ページ。上から順に読んでください。

教師あり学習・教師なし学習の解説マンガ 1/4ページ教師あり学習・教師なし学習の解説マンガ 2/4ページ教師あり学習・教師なし学習の解説マンガ 3/4ページ教師あり学習・教師なし学習の解説マンガ 4/4ページ

このマンガのページ マンガ一覧

2つの仕組み:ルールベースと機械学習

AI に知的な振る舞いをさせる方法は、大きく2つあります。

ルールベースは、人間が「もし〜ならば〜する」という条件と処理をあらかじめ書き、AI がそのルールに従って判断する方式です。仕組みが分かりやすく、判断の根拠を説明できる利点がある一方、ルールに書かれていない状況には対応できず、ルールが増えると保守が難しくなります。1980年代のエキスパートシステムがこの方式の代表です。

機械学習は、大量のデータからパターンや規則性をコンピュータ自身が見つけ出す方式です。人間がルールを書かなくても、データが多ければ精度が上がります。現在の AI の主流はこちらで、生成AIも機械学習(その中のディープラーニング)の成果です。

機械学習の3つの手法

手法 与えるもの 代表的な用途
教師あり学習 入力データと正解(ラベル)のペア 画像分類、迷惑メール判定、売上予測
教師なし学習 正解のないデータ クラスタリング(グループ分け)、次元削減
強化学習 行動の結果に対する報酬 囲碁・将棋のAI、ロボットの制御

教師あり学習は、「この画像は猫」「このメールは迷惑メール」のように正解ラベル付きのデータで学習します。分類(カテゴリを当てる)と回帰(数値を予測する)に分かれます。

教師なし学習は、正解を与えずにデータの構造を見つけます。似たデータをまとめるクラスタリング(顧客のグループ分けなど)と、データの特徴を保ったまま変数の数を減らす次元削減が代表です。

強化学習は、エージェントが環境の中で行動を選び、得られる報酬が最大になるように試行錯誤で学びます。正解を教えるのではなく「結果の良し悪し」を返す点が教師あり学習と違います。

このほかに、少量のラベル付きデータと大量のラベルなしデータを組み合わせる半教師あり学習があります。ラベル付けの手間を減らせるのが利点です。

学習済みモデル

データで学習を終え、重み(パラメータ)が定まって、新しい入力に対して予測や分類ができる状態になったモデルを学習済みモデルと呼びます。ChatGPT のような生成AIも、巨大な学習済みモデルを利用者が使っている形です。

ノーフリーランチ定理

「あらゆる問題に対して常に最も優れた性能を発揮する万能のアルゴリズムは存在しない」という定理です。すべての問題で平均すると、どのアルゴリズムも性能に差がなくなることを示しており、「問題に応じて適切な手法を選ぶ必要がある」という教訓として引用されます。「データを増やせば必ず解決する」「計算資源を増やせば何でも解ける」といった主張とは正反対の内容です。

試験で問われる観点

この節の練習問題(16問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    人間があらかじめ「もし〜ならば〜する」という条件と処理を記述し、AIがそれに従って判断する方式を何と呼ぶか。正しいものを1つ選びなさい。
    1. 1ルールベース
    2. 2教師あり学習
    3. 3パターン認識
    4. 4確率モデル
    答えと解説

    正解: 1

    人間が条件と処理(if-thenルール)を書き、AIがそのルールに従って動く方式をルールベースと呼びます。ルールに無い状況には対応できないのが弱点です。機械学習はデータからパターンを学ぶ方式で、強化学習は機械学習の一手法、転移学習は学習済みモデルを別の課題に流用する手法であり、いずれも人間がルールを書く方式ではありません。

  2. 問2
    「入力データと、それに対応する正解(ラベル)のペアを大量に与えて学習させる」機械学習の手法として正しいものを1つ選びなさい。
    1. 1クラスタリング
    2. 2教師あり学習
    3. 3教師なし学習
    4. 4強化学習
    答えと解説

    正解: 2

    正解ラベル付きのデータで学習するのが教師あり学習です。画像に「猫」「犬」のラベルを付けて学習させる画像分類や、過去の売上から将来を予測する回帰が代表例です。教師なし学習は正解を与えずデータの構造を見つける手法、強化学習は報酬をもとに行動を学ぶ手法、クラスタリングは教師なし学習の一種で、いずれもラベル付きデータを前提としません。

  3. 問3
    教師なし学習の代表的な用途の組み合わせとして、最も適切なものを1つ選びなさい。
    1. 1囲碁の対局とゲームの攻略
    2. 2文章の校正と翻訳
    3. 3クラスタリングと次元削減
    4. 4画像のラベル付き分類と売上予測
    答えと解説

    正解: 3

    教師なし学習は正解ラベルを与えず、データ自体の構造を見つける手法です。似たデータをグループ分けするクラスタリングと、データの特徴を保ちながら変数の数を減らす次元削減が代表的な用途です。「ラベル付き分類と売上予測」は正解ラベルを使う教師あり学習、「囲碁の対局とゲームの攻略」は報酬をもとに行動を学ぶ強化学習の典型例です。「文章の校正と翻訳」は生成AI(大規模言語モデル)の活用例で、教師なし学習の用途の説明ではありません。

  4. 問4
    「エージェントが環境の中で行動を選び、その結果得られる報酬が最大になるように試行錯誤で学習する」手法として正しいものを1つ選びなさい。
    1. 1教師あり学習
    2. 2半教師あり学習
    3. 3正則化
    4. 4強化学習
    答えと解説

    正解: 4

    報酬を手がかりに、より良い行動を試行錯誤で身につけるのが強化学習です。囲碁や将棋のAI、ロボットの歩行制御などで使われます。教師あり学習は正解ラベル、半教師あり学習は少量のラベル付きデータと大量のラベルなしデータを組み合わせる手法で、報酬という考え方は使いません。正則化は過学習を防ぐための技法であり、学習手法の分類ではありません。

  5. 問5
    半教師あり学習の説明として、最も適切なものを1つ選びなさい。
    1. 1少量のラベル付きデータと大量のラベルなしデータを組み合わせて学習する手法
    2. 2大量のラベル付きデータのうち半分だけを使い、残りは検証に回して学習する手法
    3. 3教師あり学習と強化学習を交互に切り替えながら同じデータで学習する手法
    4. 4人間の教師が学習の途中まで正解を示し、残りの半分は答えを与えない手法
    答えと解説

    正解: 1

    ラベル付けには手間と費用がかかるため、少量のラベル付きデータと大量のラベルなしデータを併用して学習させるのが半教師あり学習です。「人間が途中で半分だけ答えを教える」は言葉の印象からの誤解、「教師あり学習と強化学習を交互に行う」は別の手法の組み合わせで、半教師あり学習の定義ではありません。「データの半分を検証用に取り分ける」は訓練用と検証用にデータを分ける「ホールドアウト」の考え方で、学習手法の名称ではありません。

  6. 問6
    機械学習における「ノーフリーランチ定理」が意味する内容として、最も適切なものを1つ選びなさい。
    1. 1計算資源を増やせば、どんな問題でも解けるようになる。
    2. 2あらゆる問題に対して常に最も優れた性能を発揮する万能のアルゴリズムは存在しない。
    3. 3無料で公開されている学習済みモデルは商用利用できない。
    4. 4学習データが多ければ多いほど、どのアルゴリズムでも必ず精度が上がる。
    答えと解説

    正解: 2

    ノーフリーランチ定理は、すべての問題で平均するとどのアルゴリズムも性能に差がなく、「どんな問題にも最適な万能アルゴリズムは存在しない」ことを示す定理です。問題ごとに適した手法を選ぶ必要がある、という教訓として引用されます。「無料の学習済みモデルは商用利用できない」はライセンスの話で無関係です。「データを増やせば必ず精度が上がる」「計算資源を増やせば何でも解ける」は、資源を増やせば必ず解決するという主張で、定理の内容とは異なります。

  7. 問7
    ある企業が、問い合わせメールを「請求」「技術」「その他」に自動で振り分けたいと考えている。過去の問い合わせメール数万件に担当者が分類済みのラベルが付いている。この状況で最も適した方式を1つ選びなさい。
    1. 1メールをランダムに振り分けて報酬を与える強化学習
    2. 2ラベルを捨ててクラスタリングを行う教師なし学習
    3. 3ラベル付きの過去メールを使って分類モデルを作る教師あり学習
    4. 4担当者が思いつく限りのキーワードをすべてルールとして書き出すルールベース
    答えと解説

    正解: 3

    正解ラベル付きの大量データが既にある場合、それを使って分類モデルを学習させる教師あり学習が最も適しています。ルールベースはキーワードに無い表現に対応できず、保守も大変です。強化学習は行動に対する報酬を設計する必要があり、分類作業には向きません。せっかくのラベルを捨ててクラスタリングするのは、情報を無駄にする選択です。

  8. 問8
    機械学習において「学習済みモデル」とは何を指すか。最も適切なものを1つ選びなさい。
    1. 1学習に使うために人間がラベル付けや整形を終え、モデルに入力できる状態になった訓練データ
    2. 2モデルの重みを学習させるためにGPUを多数搭載し、大量の計算を並列に処理するサーバー
    3. 3学習の途中で誤差が下がらなくなり、データを追加しても予測精度が改善しなくなったモデル
    4. 4データから学習を終え、新しい入力に対して予測や分類ができる状態になったモデル
    答えと解説

    正解: 4

    学習済みモデルとは、訓練データによる学習を終え、パラメータ(重み)が定まって新しい入力に対して推論できるようになったモデルのことです。ChatGPTなどの生成AIも、巨大な学習済みモデルを利用者が使っている形になります。「人間が整理した訓練データ」はデータそのもの、「GPUサーバー」は計算資源の説明で、「学習が途中で止まったモデル」は学習済みという言葉の意味を取り違えています。

  9. 問9
    過去5年分の問い合わせメール10万件に、担当者が付けた「請求」「技術」「解約」の分類ラベルがある。新しいメールを自動で分類したい。最も適した手法を1つ選びなさい。
    1. 1分類結果に対する報酬を設定し、試行錯誤で最適な行動を学ぶ強化学習を使う
    2. 2担当者が分類の条件を「もし〜ならば」の形ですべて書き出すルールベースを使う
    3. 3ラベル付きのデータが大量にあるので、入力と正解の組で学習する教師あり学習を使う
    4. 4正解を与えずにメールを似たもの同士にまとめる教師なし学習のクラスタリングを使う
    答えと解説

    正解: 3

    入力(メール本文)と正解(分類ラベル)の組が10万件そろっているので、教師あり学習の分類が最も適します。教師なし学習は正解を使わずにデータの構造を見つける手法で、せっかくのラベルを活かせません。強化学習は行動と報酬で学ぶ手法で、分類済みデータがある場面には向きません。ルールベースは自由な文章の例外に対応できず、ルールの保守が難しくなります。

  10. 問10
    ECサイトの購買履歴から、正解ラベルのない状態で顧客を購買傾向の似たグループに分けたい。最も適した手法を1つ選びなさい。
    1. 1教師あり学習の回帰で、各顧客の次回購入金額を数値として予測する
    2. 2強化学習で、顧客への働きかけの結果を報酬として最適な施策を学ぶ
    3. 3半教師あり学習で、少数の正解ラベルから残りのラベルを推定する
    4. 4教師なし学習のクラスタリングで、似た購買履歴の顧客を自動的にまとめる
    答えと解説

    正解: 4

    正解ラベルがなく、データを似たもの同士にまとめたい場面は教師なし学習のクラスタリングの典型です。回帰は正解の数値を使って予測する教師あり学習で、ラベルがない状況には合いません。強化学習は行動と報酬の仕組みで、グループ分けの手法ではありません。半教師あり学習は少量のラベルが前提で、ここではラベルが存在しません。

  11. 問11
    強化学習に関する記述として、不適切なものを1つ選びなさい。
    1. 1正解ラベル付きの大量データを事前に用意し、入力と正解の対応を直接学習させる手法である
    2. 2エージェントが環境の中で行動を選び、得られる報酬が最大になるように試行錯誤で学ぶ
    3. 3正解そのものを教えるのではなく、行動の結果の良し悪しを返す点が教師あり学習と異なる
    4. 4囲碁や将棋のAI、ロボットの制御など、行動の連続とその結果が評価できる課題に使われる
    答えと解説

    正解: 1

    強化学習は、行動の結果として得られる報酬をもとに、報酬が最大になる行動を試行錯誤で学ぶ手法です。正解ラベル付きデータで入力と正解の対応を学ぶのは教師あり学習の説明で、強化学習の記述としては不適切です。囲碁・将棋のAIやロボット制御は強化学習の代表的な用途です。

  12. 問12
    半教師あり学習が有効な場面と、その利点の説明として最も適切なものを1つ選びなさい。
    1. 1人間がルールの半分を書き、残りの半分をデータから自動生成させるルールベースの一種
    2. 2少量のラベル付きデータと大量のラベルなしデータを組み合わせて学習し、ラベル付けの手間を減らす手法
    3. 3学習データの半分だけを使って学習し、残りの半分を精度の検証に使うことで過学習を防ぐ手法
    4. 4教師あり学習と強化学習を半分ずつ組み合わせ、正解ラベルと報酬の両方から同時に学ぶ手法
    答えと解説

    正解: 2

    半教師あり学習は、少量のラベル付きデータと大量のラベルなしデータを組み合わせる手法で、全データにラベルを付ける手間を減らせるのが利点です。データを半分に分けて検証に使うのは学習データと検証データの分割の話で、別の概念です。教師あり学習と強化学習の組み合わせや、ルールの半自動生成という説明は誤りです。

  13. 問13
    ルールベースのAIに関する記述として、不適切なものを1つ選びなさい。
    1. 1仕組みが分かりやすく、どのルールで判断したかという根拠を説明しやすい利点がある
    2. 2ルールに書かれていない状況には対応できず、ルールが増えると保守が難しくなる
    3. 3大量のデータからパターンを自動で見つけるため、データが多いほど精度が上がる
    4. 4人間が「もし〜ならば〜する」という条件と処理をあらかじめ書き、AIはそのルールに従って判断する
    答えと解説

    正解: 3

    ルールベースは人間が書いたルールに従って判断する方式で、根拠を説明しやすい反面、ルールにない状況に対応できず、ルールが増えると保守が難しくなります。「大量のデータからパターンを自動で見つけ、データが多いほど精度が上がる」のは機械学習の説明で、ルールベースの記述としては不適切です。

  14. 問14
    「学習済みモデル」の説明として、最も適切なものを1つ選びなさい。
    1. 1学習に使うデータを集めて整理し、ラベルを付け終えた状態のデータセットのこと
    2. 2人間が書いたルールをすべて登録し終え、例外なく判断できるようになったルールベースの仕組み
    3. 3学習の途中で精度が下がり始めたため、学習を途中で止めた未完成のモデルのこと
    4. 4データで学習を終えて重みが定まり、新しい入力に対して予測や分類ができる状態になったモデル
    答えと解説

    正解: 4

    学習済みモデルは、データで学習を終えて重み(パラメータ)が定まり、新しい入力に対して予測や分類ができる状態のモデルです。ChatGPTのような生成AIも、巨大な学習済みモデルを利用者が使っている形です。ラベル付けを終えたデータセット、ルール登録済みのルールベース、途中で止めた未完成のモデルはいずれも学習済みモデルの定義ではありません。

  15. 問15
    「画像分類で高い精度を出した手法だから、売上予測でも同じ手法を使えば必ず最高の精度が出る」という提案に対する指摘として、最も適切なものを1つ選びなさい。
    1. 1ノーフリーランチ定理が示すとおり万能の手法はなく、問題に応じて手法を選び直す必要がある
    2. 2画像分類の手法は売上予測には使えないと法律で定められているため、提案自体が認められない
    3. 3データ量を2倍にすれば、どの手法でも同じ精度に収束するので、手法の選択は重要でない
    4. 4精度は手法ではなく計算機の性能だけで決まるため、より高性能なGPUを用意すれば解決する
    答えと解説

    正解: 1

    ノーフリーランチ定理は「あらゆる問題に対して常に最も優れた性能を発揮する万能のアルゴリズムは存在しない」という定理で、問題に応じて適切な手法を選ぶ必要があることの根拠になります。手法の転用を法律が禁じているという事実はなく、データ量や計算機の性能だけで手法の違いが消えるわけでもありません。

  16. 問16
    教師なし学習における「次元削減」の説明として、最も適切なものを1つ選びなさい。
    1. 1行動の結果として得られる報酬を集計し、最適な行動を選ぶ処理
    2. 2データの特徴をできるだけ保ったまま、扱う変数の数を減らす処理
    3. 3似たデータ同士をまとめて、いくつかのグループに分ける処理
    4. 4正解ラベルの付いたデータを増やして、分類の精度を高める処理
    答えと解説

    正解: 2

    次元削減は、データの特徴を保ったまま変数の数を減らす教師なし学習の代表的な処理で、可視化や計算量の削減に使われます。似たデータをまとめるのはクラスタリング、正解ラベル付きデータで学ぶのは教師あり学習、報酬で行動を選ぶのは強化学習の説明です。