G検定 › Web参考書 › 第6章

転移学習とファインチューニング(事前学習済みモデル、Few-shot、自己教師あり学習、破滅的忘却)

第6章 ディープラーニングの応用例 / 節 6

シラバスのキーワード: 事前学習事前学習済みモデル転移学習ファインチューニングFew-shotOne-shot自己教師あり学習半教師あり学習破滅的忘却

本文を読んだあと、覚えているか確認してください。

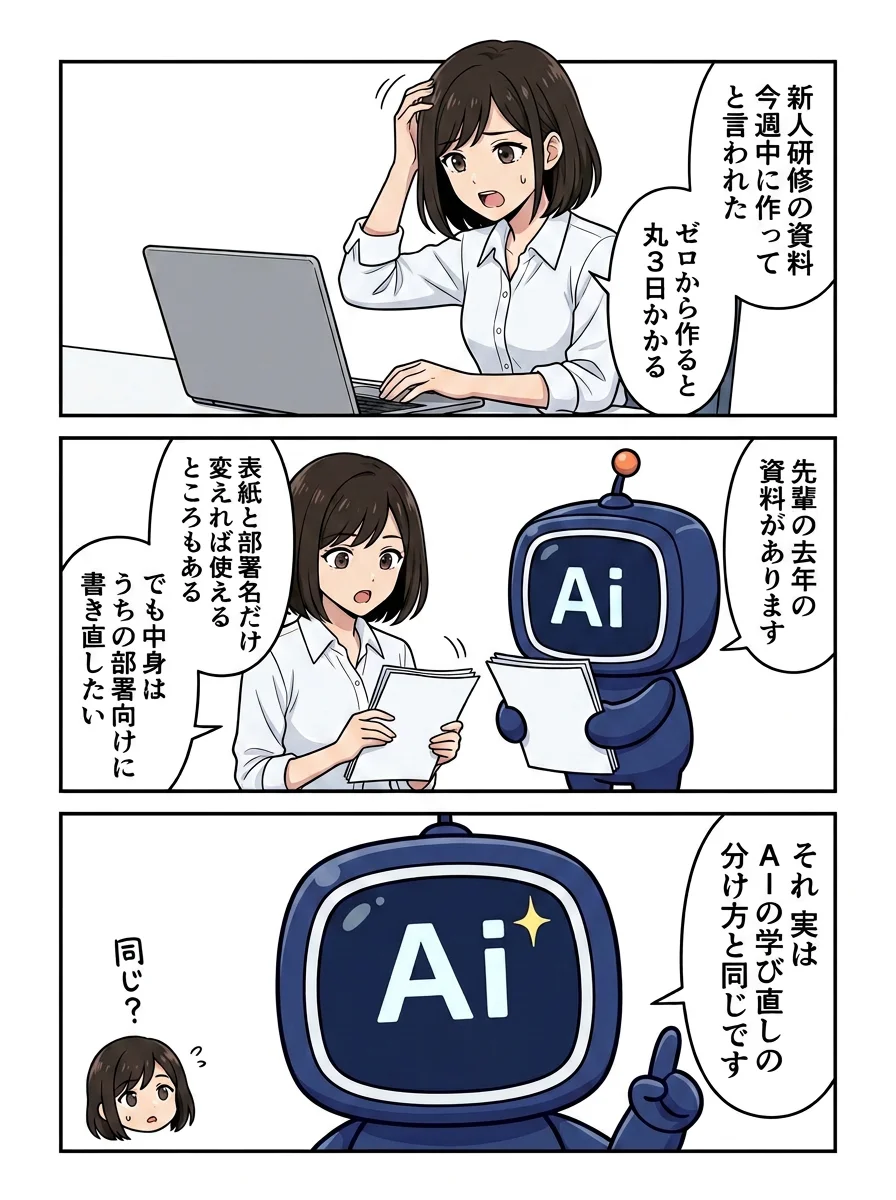
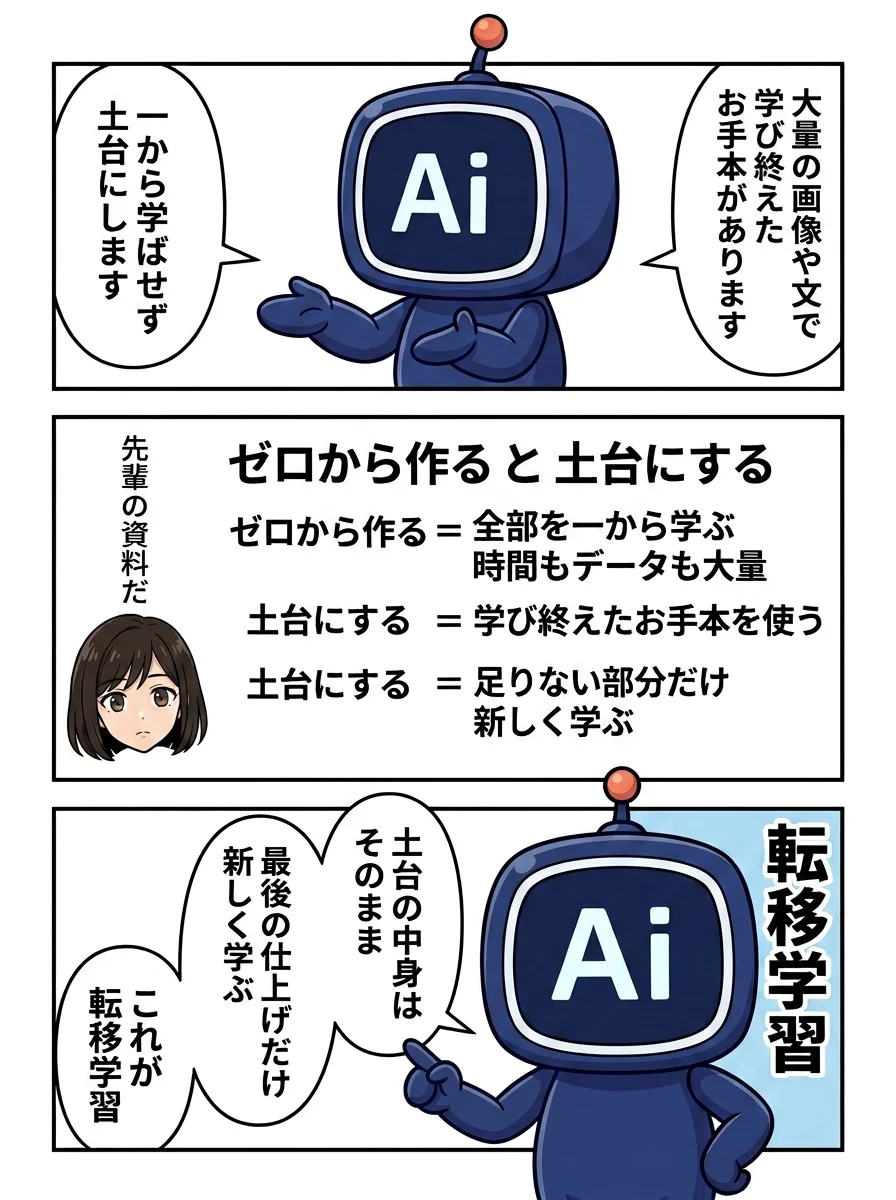
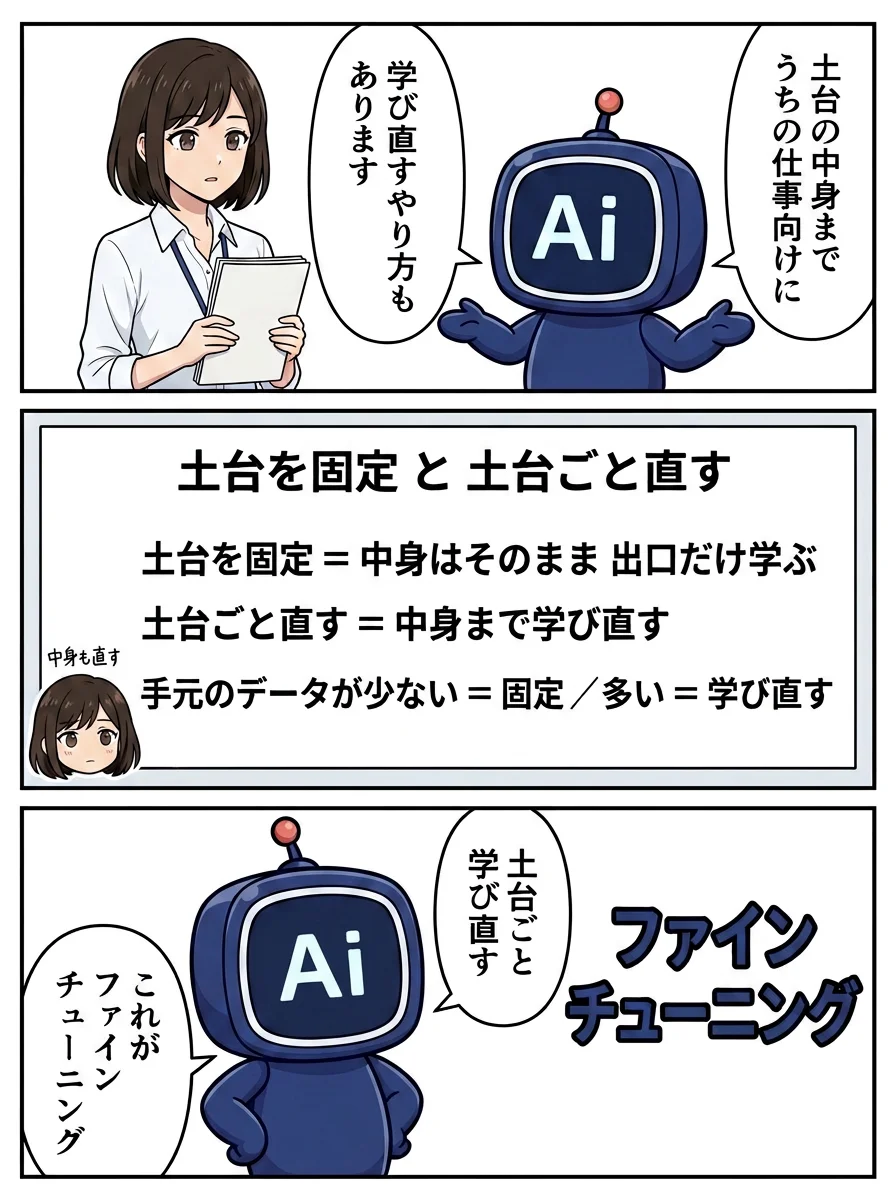
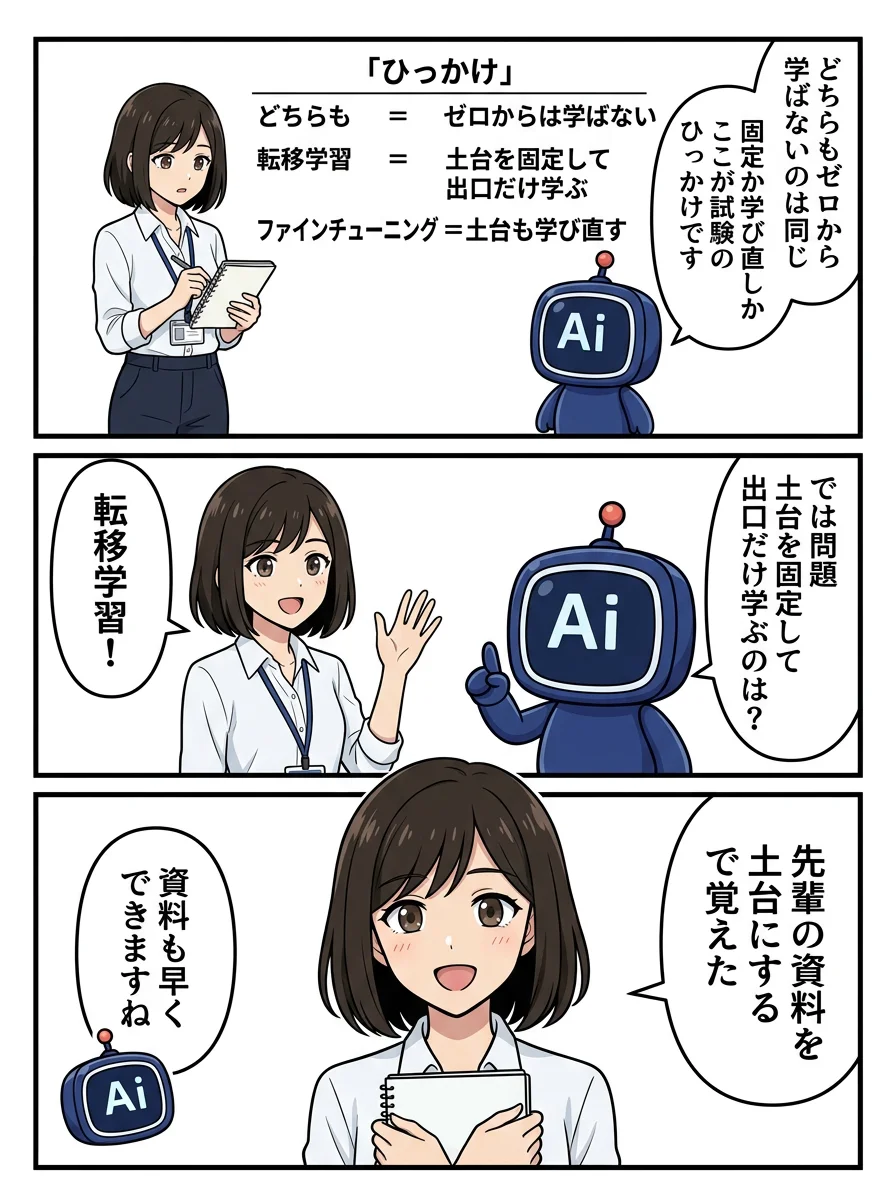
マンガで学ぶ 転移学習とファインチューニング

Ai と みお の4ページ。上から順に読んでください。

転移学習とファインチューニングの解説マンガ 1/4ページ転移学習とファインチューニングの解説マンガ 2/4ページ転移学習とファインチューニングの解説マンガ 3/4ページ転移学習とファインチューニングの解説マンガ 4/4ページ

このマンガのページ マンガ一覧

転移学習とファインチューニング

ImageNetのような大規模データで事前学習したモデルの知識を、データが少ない別のタスクに活用する方法です。転移学習は事前学習済みの層を固定して特徴抽出器として使い、出力層だけを新しく学習します。ファインチューニングは事前学習済みの重みを初期値として、全体または一部の層を新しいデータで再学習します。どちらもゼロから学習するより少ないデータで高い精度に到達できます。

Few-shot、One-shot、Zero-shot

新しいタスクに与える例の数によって、Few-shot(数例)、One-shot(1例)、Zero-shot(例なし、タスクの説明だけ)と呼び分けます。LLMではプロンプトに例を含める文脈内学習として、CLIPでは学習していないクラスの分類として現れます。

自己教師あり学習と半教師あり学習

ラベル付き画像が少なくラベルなし画像が大量にある場合、事前学習済みモデルのファインチューニングと、半教師あり・自己教師あり学習の併用が有効です。

破滅的忘却

学習済みのモデルに新しいタスクを追加で学習させると、以前のタスクの性能が大きく低下する現象です。継続学習の主要な課題で、重要なパラメータの変化を抑える手法などが研究されています。

試験で問われる観点

この節の練習問題(6問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    転移学習とファインチューニングの説明として、最も適切なものを選びなさい。
    1. 1大規模データで事前学習したモデルの重みをすべて捨て、新しいタスクのデータで構造だけを再利用してゼロから学習するのが転移学習で、事前学習済みモデルの出力層だけを取り替えて重みを固定したまま使うのがファインチューニングである
    2. 2大規模データで事前学習したモデルの知識を別のタスクに活かす考え方が転移学習で、事前学習済みモデルの一部または全体の重みを新しいタスクのデータで追加学習して調整するのがファインチューニングである。少量のデータで高い精度が得られる
    3. 3学習済みモデルを別のコンピュータやクラウド環境に移して推論を行う考え方が転移学習で、学習率やバッチサイズなどのハイパーパラメータを細かく調整して精度を高めるのがファインチューニングである。いずれも重みは変更しない
    4. 4大規模データで事前学習したモデルの知識を別のタスクに活かす考え方がファインチューニングで、事前学習済みモデルの一部または全体の重みを新しいタスクのデータで追加学習して調整するのが転移学習である。大量のデータがなければ精度は得られない
    答えと解説

    正解: 2

    ImageNetで学習した画像モデルや大規模テキストで学習した言語モデルは、汎用的な特徴を獲得しており、それを土台に新しいタスクに適応させると、ゼロからの学習より少ないデータと計算で高精度が得られます。出力層だけを付け替えて特徴抽出器として使う方法から、全層を再学習する方法まで、調整の範囲は様々です。ごく少数の例だけで適応するFew-shot・One-shot学習もこの延長にあります。

  2. 問2
    「自己教師あり学習」と「破滅的忘却」の説明の組み合わせとして正しいものを選びなさい。
    1. 1自己教師あり学習: 環境から得られる報酬を手がかりに、エージェントが試行錯誤しながら行動を学ぶ方法。破滅的忘却: 深い層のネットワークで誤差の勾配が入力層に近づくほど小さくなり、学習が進まなくなる現象
    2. 2自己教師あり学習: 新しいタスクを追加学習すると、以前に学習したタスクの性能が大きく低下する現象。破滅的忘却: ラベルのないデータから、一部を隠して残りから予測するなどデータ自身から作った課題で事前学習する方法
    3. 3自己教師あり学習: ラベルのないデータから、一部を隠して残りから予測するなどデータ自身から作った課題で事前学習する方法。破滅的忘却: 新しいタスクを追加学習すると、以前に学習したタスクの性能が大きく低下する現象
    4. 4自己教師あり学習: 人間が付けた正解ラベルの一部だけを使い、残りのデータには自動で仮のラベルを付けて学習する方法。破滅的忘却: 訓練データに過剰に適合し、未知のデータに対する性能が大きく低下する現象
    答えと解説

    正解: 3

    自己教師あり学習は、BERTのマスクした単語の予測や、画像の一部の復元・回転の推定のように、データから自動的に作った疑似的な正解を使って表現を学習する方法で、大量のラベルなしデータを活かせるため大規模モデルの事前学習の中心になっています。破滅的忘却は、ニューラルネットワークを新しいタスクで追加学習すると重みが上書きされ、以前のタスクの性能が急激に落ちる現象で、継続学習における主要な課題です。

  3. 問3
    Few-shot、One-shot、Zero-shotの説明の組み合わせとして正しいものを選びなさい。
    1. 1Few-shot:例を一切与えずにタスクの説明だけで対応する。One-shot:1つの例だけで対応する。Zero-shot:数個の例だけで新しいタスクを学習・実行する
    2. 2Few-shot:数個の例だけで新しいタスクを学習・実行する。One-shot:1つの例だけで対応する。Zero-shot:例を一切与えずにタスクの説明だけで対応する
    3. 3Few-shot:数千枚の画像で事前学習してから転移する。One-shot:1エポックだけ学習して早期終了する。Zero-shot:学習率を0にしてパラメータを固定する
    4. 4Few-shot:数個のモデルを組み合わせて推論する。One-shot:1つのモデルだけで推論する。Zero-shot:学習済みモデルを使わずにルールベースで対応する
    答えと解説

    正解: 2

    事前学習済みモデルの活用では、新しいタスクに与える例の数によってFew-shot(数例)、One-shot(1例)、Zero-shot(0例)と呼び分けます。LLMではプロンプトに例を含める文脈内学習として、CLIPのようなマルチモーダルモデルでは学習していないクラスの分類として、この考え方が使われます。

  4. 問4
    製品の外観検査AIを作りたいが、ラベル付きの画像は500枚しかなく、ラベルなしの画像は10万枚ある。この状況で精度を高めるアプローチとして最も適切なものを選びなさい。
    1. 1ラベルなし画像は精度を下げる原因となるため学習から除外し、ラベル付き500枚に対して事前学習なしの小さなモデルを構築して過学習を避ける
    2. 2ラベル付き500枚だけで大規模なCNNをゼロから学習し、精度が不足する場合は同じ500枚を100回複製して訓練データを5万枚に増やしてから再学習する
    3. 3ImageNetなどで事前学習済みのモデルを転移学習・ファインチューニングし、さらにラベルなし画像を活用する半教師あり学習や自己教師あり学習を検討する
    4. 4ラベルなし画像10万枚を使ってImageNetと同じ1,000クラスの分類モデルをゼロから教師あり学習し、ラベル付き500枚は最終評価のテストデータとしてのみ用いる
    答えと解説

    正解: 3

    ラベル付きデータが少ない場合、大規模データで事前学習したモデルを出発点にする転移学習・ファインチューニングが有効です。さらに大量のラベルなし画像は、半教師あり学習(疑似ラベルなど)や自己教師あり学習で特徴表現の学習に活用できます。ゼロからの学習は過学習し、画像の単純な複製はデータの多様性を増やしません。

  5. 問5
    ラベル付き画像が300枚しかない部品の分類で、事前学習済みモデルの重みを初期値にし、全体または一部の層を新しいデータで再学習させる方法として、最も適切なものを選びなさい。
    1. 1蒸留
    2. 2プルーニング
    3. 3ドメインランダマイゼーション
    4. 4ファインチューニング
    答えと解説

    正解: 4

    ファインチューニングは、事前学習済みモデルの重みを初期値として、全体または一部の層を新しいデータで再学習する方法で、少ないデータでも高い精度に到達しやすくなります。蒸留は大きな教師モデルの出力を目標に小さな生徒モデルを学習させる軽量化手法、プルーニングは寄与の小さい重みを削除する手法です。ドメインランダマイゼーションはシミュレーションの見た目や物理パラメータをランダムに変えて実環境との差に頑健にする強化学習の手法です。

  6. 問6
    既存製品の外観検査モデルに、新製品の画像だけを使って追加学習したところ、新製品は判定できるようになったが既存製品の精度が大きく低下した。この現象として最も適切なものを選びなさい。
    1. 1モード崩壊
    2. 2破滅的忘却
    3. 3データリーケージ
    4. 4敵対的サンプル(Adversarial Examples)
    答えと解説

    正解: 2

    学習済みのモデルに新しいタスクを追加で学習させると、以前のタスクの性能が大きく低下する現象を破滅的忘却といい、継続学習の主要な課題です。モード崩壊はGANが同じような画像ばかり生成する現象、データリーケージは予測時点で得られない情報の混入で検証精度が高く出る問題です。敵対的サンプルは入力に摂動を加えて誤認識させる攻撃で、追加学習による性能低下とは別の問題です。