G検定 › Web参考書 › 第4章

正則化(L1・L2正則化、ラッソ回帰とリッジ回帰、ドロップアウト)

第4章 ディープラーニングの概要 / 節 4

シラバスのキーワード: 正則化L0正則化L1正則化L2正則化ラッソ回帰リッジ回帰ドロップアウト

本文を読んだあと、覚えているか確認してください。

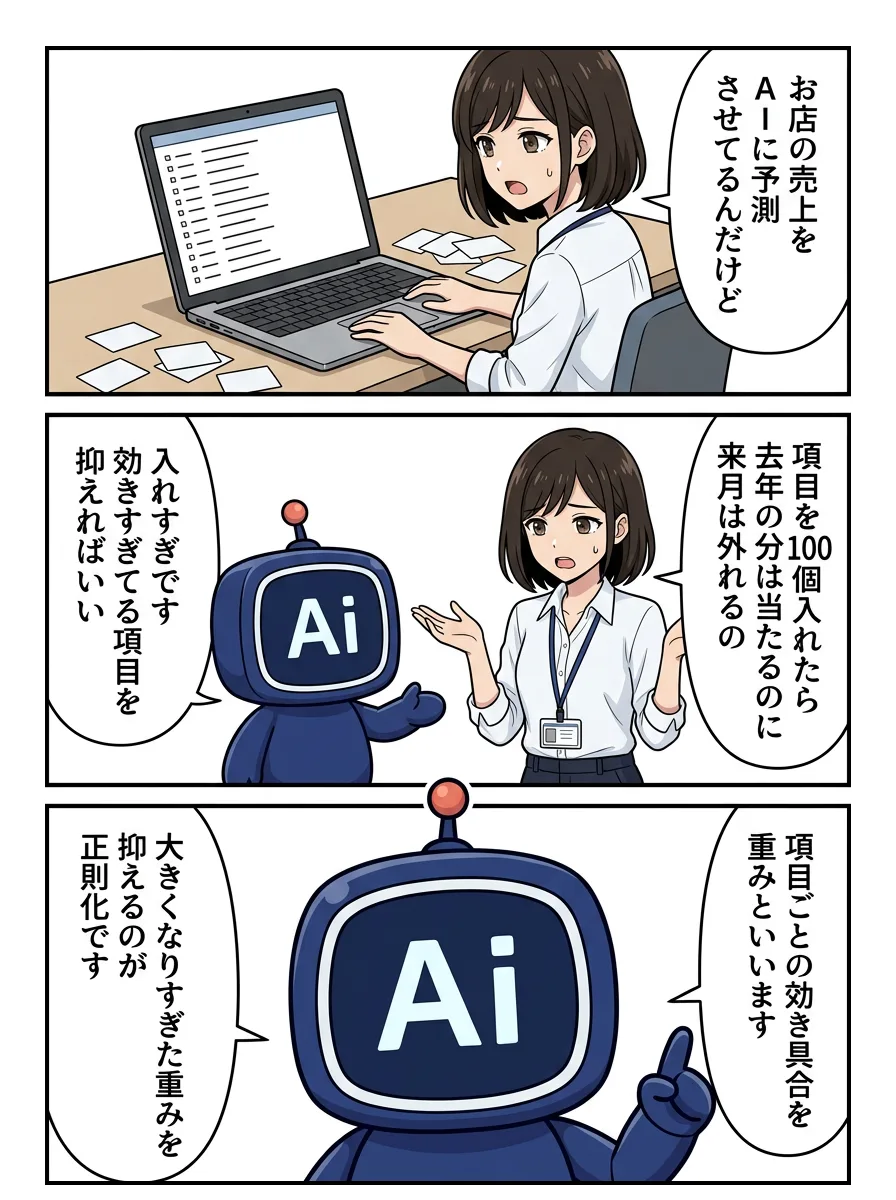
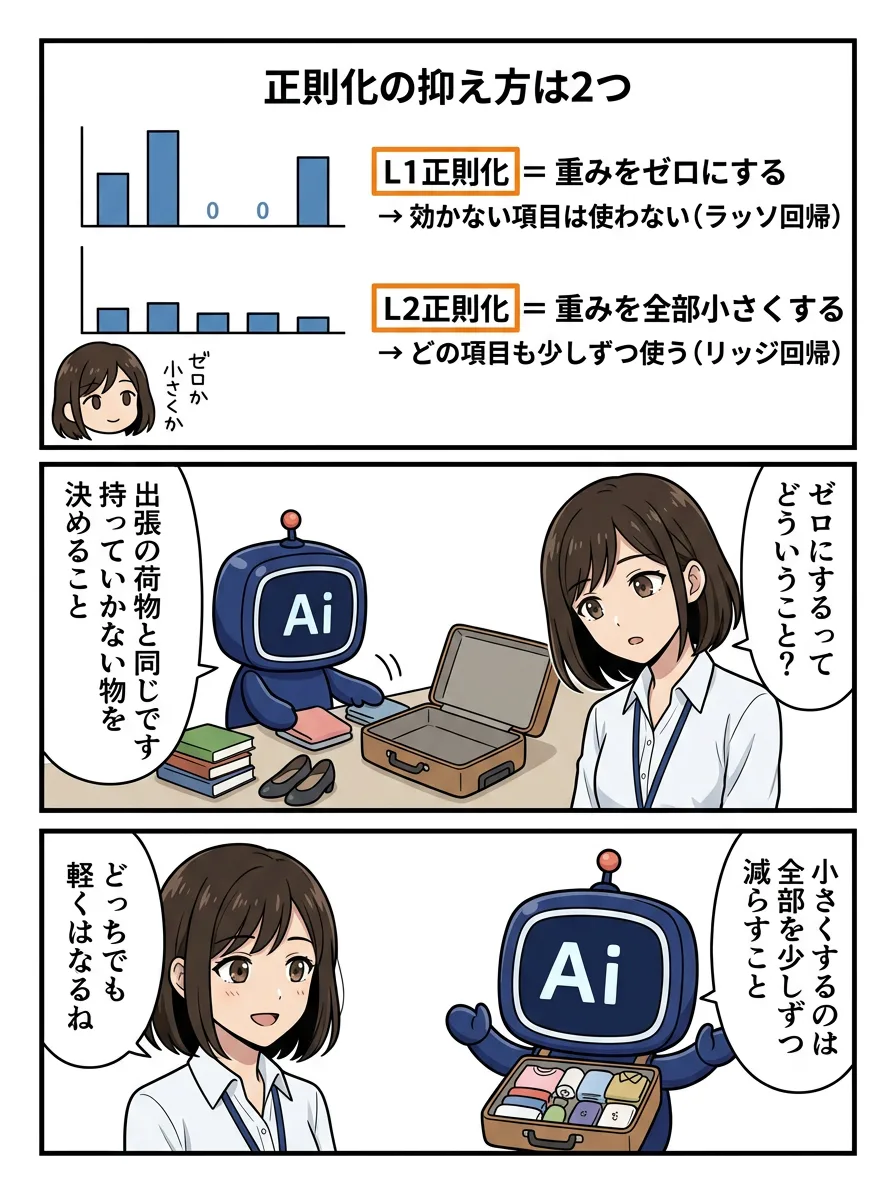
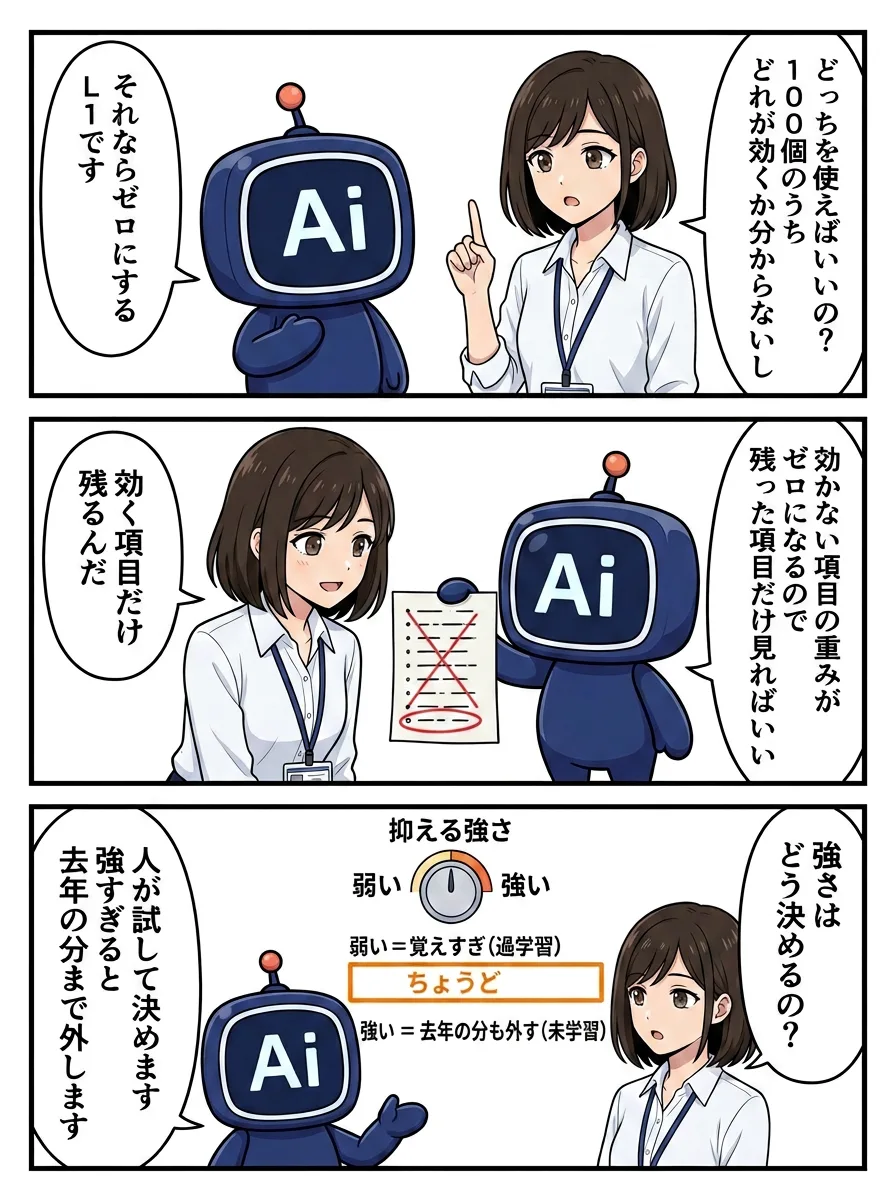
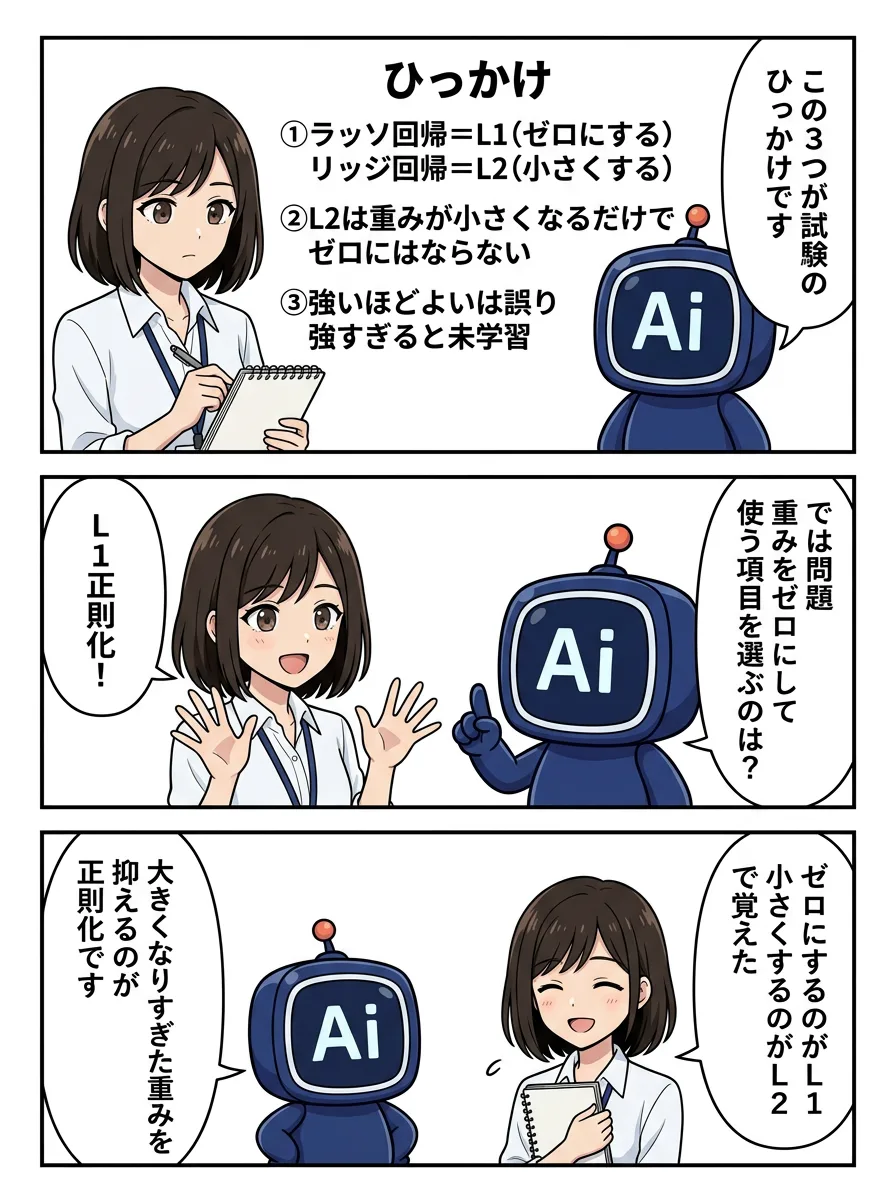
マンガで学ぶ L1・L2正則化

Ai と みお の4ページ。上から順に読んでください。

L1・L2正則化の解説マンガ 1/4ページL1・L2正則化の解説マンガ 2/4ページL1・L2正則化の解説マンガ 3/4ページL1・L2正則化の解説マンガ 4/4ページ

このマンガのページ マンガ一覧

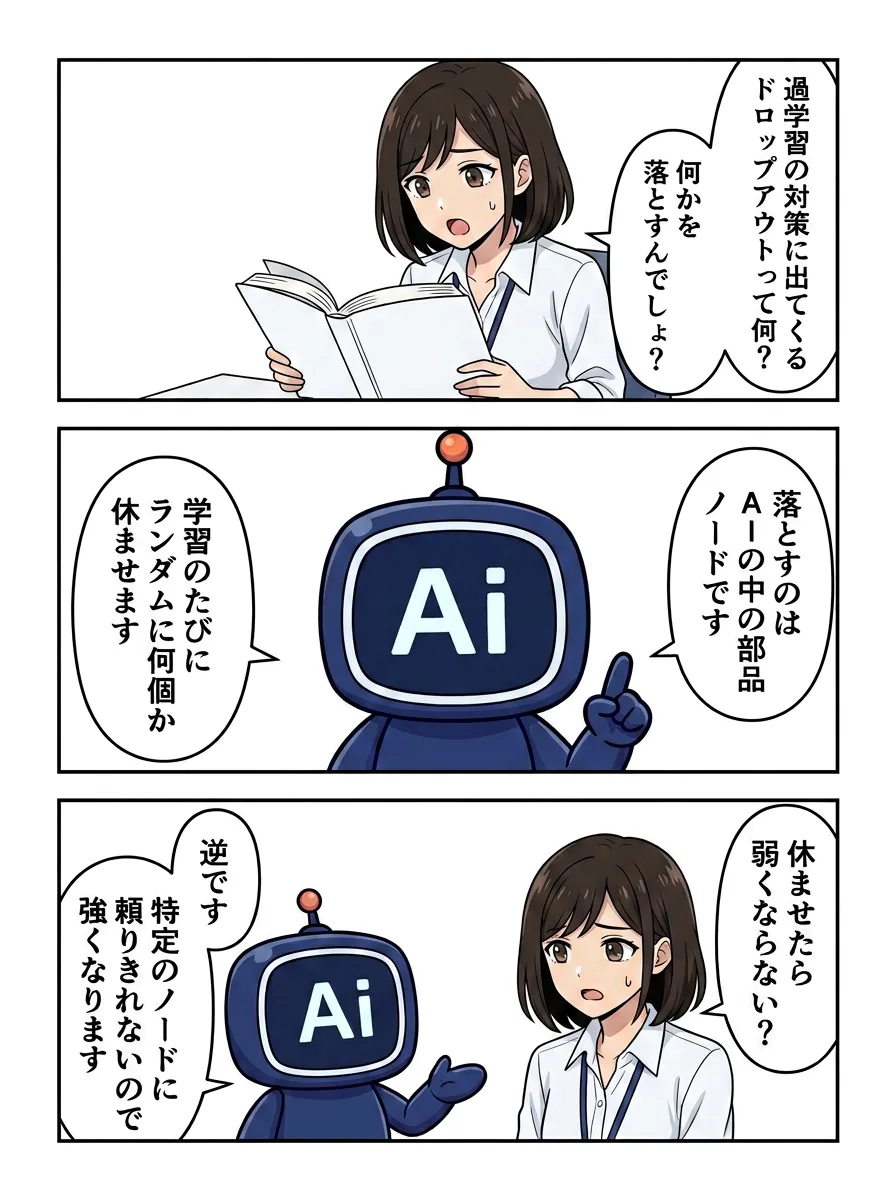
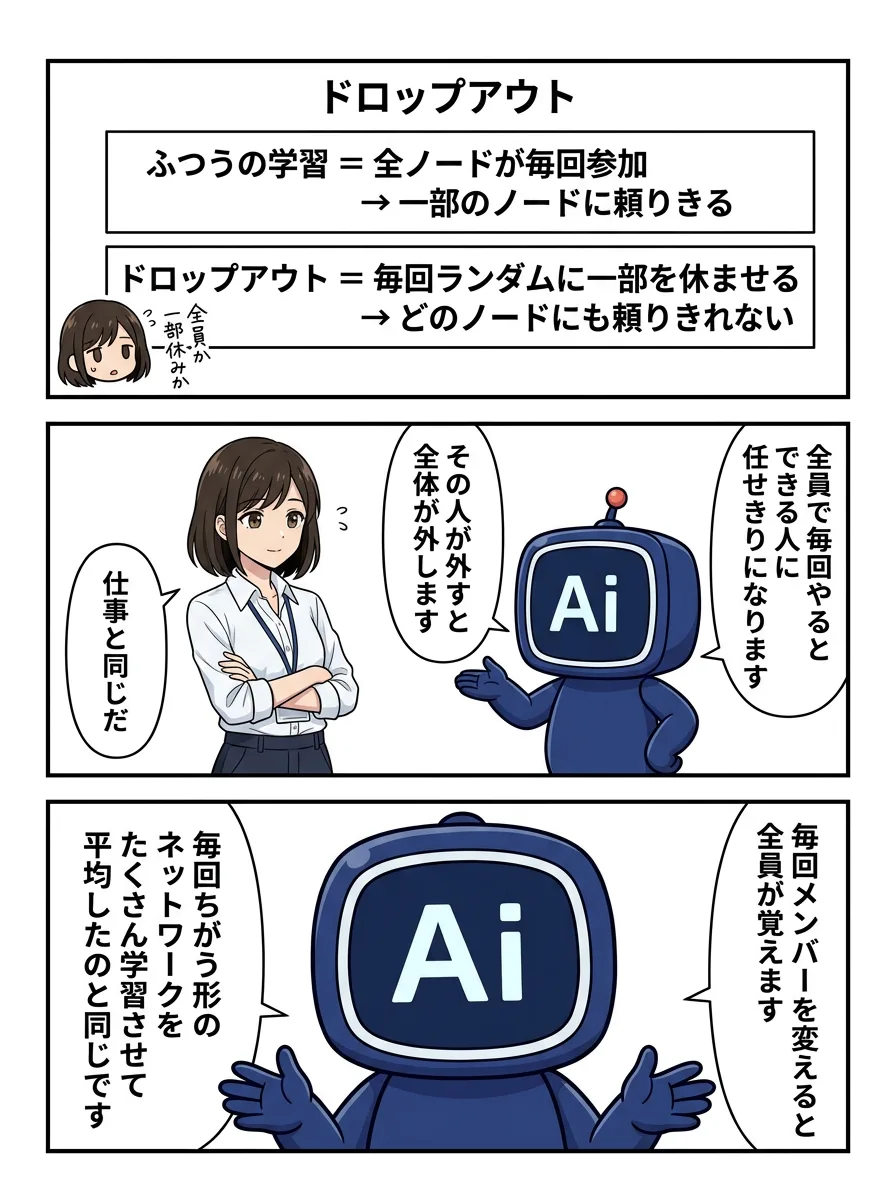
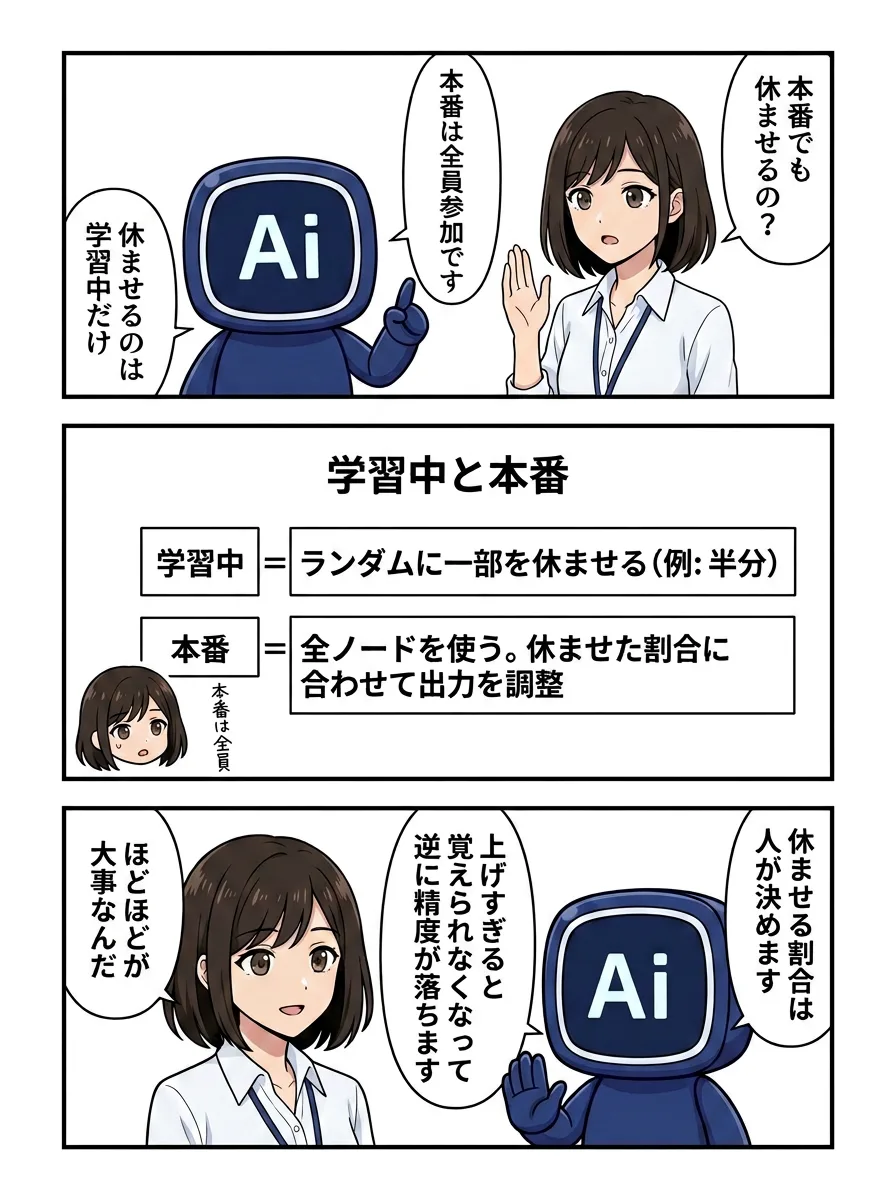
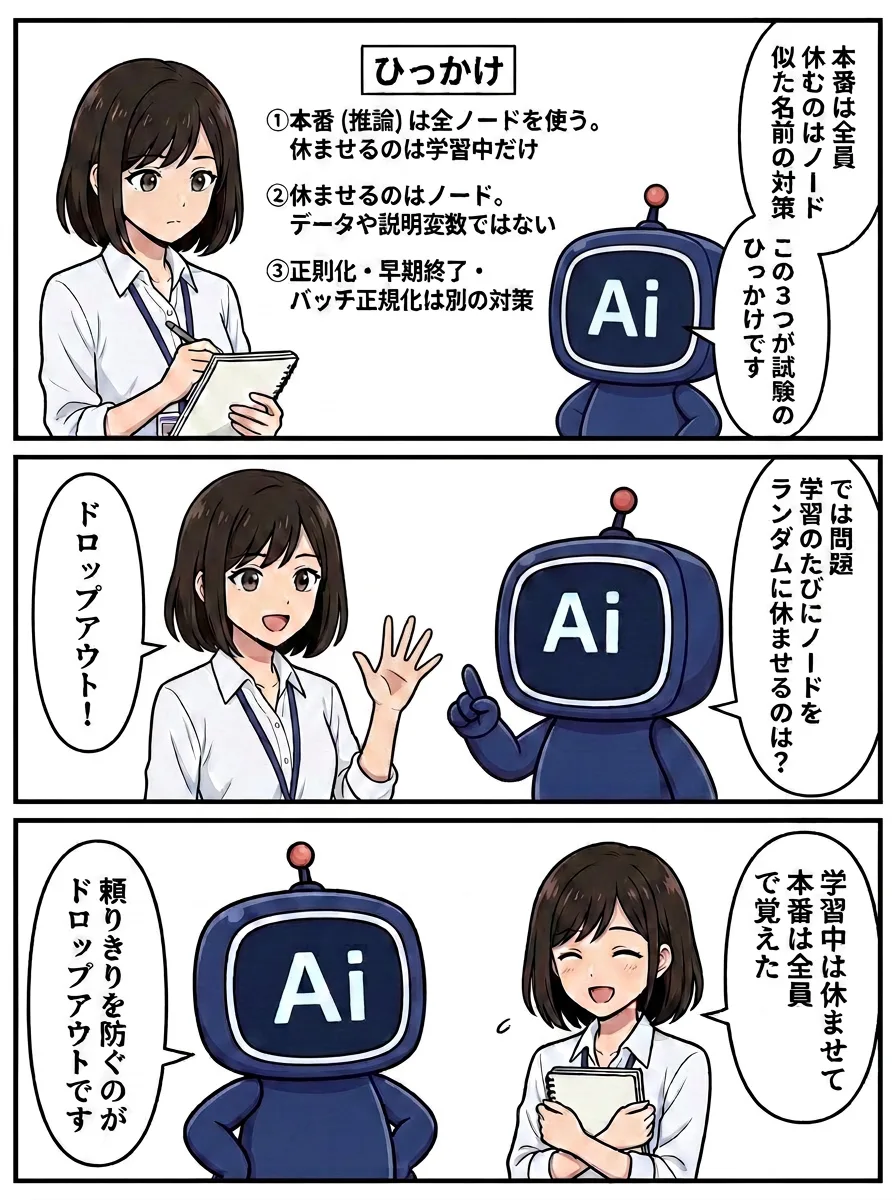
マンガで学ぶ ドロップアウト

Ai と みお の4ページ。上から順に読んでください。

ドロップアウトの解説マンガ 1/4ページドロップアウトの解説マンガ 2/4ページドロップアウトの解説マンガ 3/4ページドロップアウトの解説マンガ 4/4ページ

このマンガのページ マンガ一覧

正則化の目的

モデルが訓練データのノイズまで覚えて汎化性能が下がる過学習を防ぐため、誤差関数にパラメータの大きさや複雑さに応じた罰則項を加えて、モデルを単純に保つ手法の総称です。

L1・L2正則化

正則化 罰則 効果 線形回帰での名称
L0正則化 0でない係数の個数 理想的だが組み合わせ最適化になり計算困難 ─
L1正則化 係数の絶対値の和 一部の係数がちょうど0になり、変数選択(スパース化)の効果がある ラッソ回帰
L2正則化 係数の二乗和 係数を全体的に滑らかに小さくする。0にはなりにくい リッジ回帰

数百個の説明変数から予測に効く変数を絞り込みたい場合はL1正則化が適しています。L1とL2を組み合わせたものをElastic Netといいます。

ドロップアウト

学習のたびにランダムに選んだ一部のノードを無効化して学習する手法です。異なる部分ネットワークを多数学習させてその平均を取るアンサンブル学習に近い効果が得られ、過学習が抑えられます。推論時にはすべてのノードを使い、無効化していた割合に応じて出力を調整します。

強さの調整

正則化の強さはハイパーパラメータで、強くするほどモデルは単純になります。強くしすぎると訓練データにも当てはまらない未学習になるため、検証データで調整します。「強いほど必ず汎化性能が上がる」という記述は誤りです。

試験で問われる観点

この節の練習問題(8問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    L1正則化とL2正則化の特徴と、それぞれを線形回帰に適用した手法の名称の組み合わせとして正しいものを選びなさい。
    1. 1L1: 学習中にランダムにノードを無効化して重みの共適応を防ぐ(ドロップアウト)。L2: 検証誤差が上昇に転じた時点で学習を止めて過学習を防ぐ(早期終了)
    2. 2L1: 重みの絶対値の和にペナルティを与え、一部の重みを0にして特徴選択の効果がある(ラッソ回帰)。L2: 重みの二乗和にペナルティを与え、重みを全体的に小さくする(リッジ回帰)
    3. 3L1: 重みの二乗和にペナルティを与え、重みを全体的に小さくする(リッジ回帰)。L2: 重みの絶対値の和にペナルティを与え、一部の重みを0にして特徴選択の効果がある(ラッソ回帰)
    4. 4L1: 重みの絶対値の和にペナルティを与え、一部の重みを0にして特徴選択の効果がある(リッジ回帰)。L2: 重みの二乗和にペナルティを与え、重みを全体的に小さくする(ラッソ回帰)
    答えと解説

    正解: 2

    正則化は誤差関数に重みの大きさに応じたペナルティ項を加えて、モデルが複雑になりすぎる(過学習する)のを抑える手法です。L1正則化は重みの絶対値の和を用い、不要な特徴量の重みがちょうど0になりやすいためスパースなモデルと特徴選択の効果が得られます。L2正則化は重みの二乗和を用い、重みを全体的に小さく滑らかにします。線形回帰にL1を適用したものがラッソ回帰、L2を適用したものがリッジ回帰です。

  2. 問2
    学習のたびにランダムに選んだ一部のノードを無効化して学習し、推論時にはすべてのノードを使うことで、複数のネットワークのアンサンブルに似た効果を得て過学習を抑える手法として最も適切なものを選びなさい。
    1. 1早期終了
    2. 2データ拡張
    3. 3ドロップアウト
    4. 4バッチ正規化
    答えと解説

    正解: 3

    ドロップアウトは、学習時に一定の確率でノードをランダムに無効化することで、特定のノードへの依存を防ぎ、毎回異なる部分ネットワークを学習させる正則化手法です。推論時は全ノードを使い、出力を学習時の確率で調整します。バッチ正規化は各層の入力をミニバッチ単位で正規化して学習を安定させる手法、早期終了は検証誤差が悪化し始めたら学習を止める手法、データ拡張は訓練データを加工して水増しする手法で、いずれも過学習対策ですがドロップアウトとは仕組みが異なります。

  3. 問3
    正則化を導入する目的として、最も適切なものを選びなさい。
    1. 1モデルの表現力を最大限に高め、訓練データへの当てはまりを良くして訓練誤差を0に近づけるため
    2. 2少ない訓練データから擬似的なデータを生成し、学習に使えるデータの量を増やすため
    3. 3入力データの各特徴量の値の範囲を0〜1に揃え、スケールの違いによる学習の偏りをなくすため
    4. 4モデルの複雑さに制約を加え、訓練データへの過剰な適合(過学習)を抑えて汎化性能を高めるため
    答えと解説

    正解: 4

    正則化は、誤差関数に重みの大きさや数に応じたペナルティ(L1、L2、あるいは非ゼロの重みの個数を数えるL0など)を加えることで、モデルが訓練データの細部やノイズまで学習してしまうのを抑え、未知のデータに対する性能(汎化性能)を高めることが目的です。訓練誤差を0にすることは過学習そのもので、データ量を増やす目的でもなく、値の範囲を揃えるのは正規化(前処理)です。

  4. 問4
    数百個の説明変数を持つ回帰モデルを作る際、予測に寄与しない変数の係数を0にして、実際に使う変数を絞り込みたい。この目的に最も適した正則化を選びなさい。
    1. 1L2正則化(リッジ回帰):一部の係数がちょうど0になるため、変数選択の効果がある
    2. 2L1正則化(ラッソ回帰):一部の係数がちょうど0になるため、変数選択の効果がある
    3. 3ドロップアウト:学習時に説明変数をランダムに無効化し、寄与しない変数の係数を0にする
    4. 4バッチ正規化:各層の入力の分布を整えることで、寄与しない変数の係数が自然に0に収束する
    答えと解説

    正解: 2

    L1正則化は係数の絶対値の和を罰則に加えるため、寄与の小さい変数の係数がちょうど0になり、自動的に変数選択(スパース化)が行われます。L2正則化は係数を滑らかに小さくしますが0にはなりにくく、変数を絞る目的には向きません。ドロップアウトはニューラルネットワークの正則化、バッチ正規化は学習の安定化の手法です。

  5. 問5
    ドロップアウトを適用したニューラルネットワークの推論時(学習後に予測を行うとき)の扱いとして、最も適切なものを選びなさい。
    1. 1推論時は学習率を0にしてパラメータの更新を止め、学習時に無効化していたノードの重みも0に固定することで、出力を安定させる
    2. 2推論時はすべてのノードを使うが出力の調整は行わず、学習時より大きな値が出力されるのを防ぐために最終層の出力を再度学習し直す
    3. 3推論時はすべてのノードを使い、学習時に無効化していた割合に応じて出力を調整することで、多数のネットワークの平均を取ったのと同等の効果を得る
    4. 4推論時は学習時に無効化されたノードを恒久的に削除し、残ったノードだけの小さなネットワークとして使うことで、推論を高速化する
    答えと解説

    正解: 3

    ドロップアウトは学習時にのみノードをランダムに無効化し、推論時にはすべてのノードを使って、無効化率に応じた重みのスケーリングを行います。これにより、異なる部分ネットワークを多数学習させてその平均を取るアンサンブル学習に近い効果が得られ、過学習が抑えられます。推論時に重みを0に固定したり、最終層を学習し直したり、無効化されたノードを削除して小さなネットワークにしたりする扱いは誤りです。

  6. 問6
    正則化に関する記述として、誤っているものを選びなさい。
    1. 1L2正則化は係数の二乗和を罰則として加え、これを線形回帰に適用したものをリッジ回帰と呼ぶ
    2. 2L0正則化は0でない係数の個数そのものを罰則とするが、組み合わせ最適化になるため計算が困難で、実用ではL1正則化で代用されることが多い
    3. 3正則化の強さを決める係数はハイパーパラメータであり、大きくするほどモデルは単純になる
    4. 4正則化を強くすればするほど汎化性能は必ず向上するため、できるだけ強く設定すべきである
    答えと解説

    正解: 4

    正則化を強くしすぎるとモデルが単純になりすぎて訓練データにも当てはまらない未学習の状態になり、汎化性能はかえって悪化します。正則化の強さは検証データで調整すべきハイパーパラメータです。L2正則化とリッジ回帰、L0正則化の計算困難さ、正則化係数の性質に関する記述は正しい内容です。

  7. 問7
    正則化を強めに設定してモデルを学習したところ、訓練誤差も検証誤差もともに大きいままだった。対応として最も適切なものを選びなさい。
    1. 1正則化を弱め、検証データを見ながら強さを調整する
    2. 2正則化をさらに強め、モデルをより単純にする
    3. 3ドロップアウトで無効化するノードの割合を上げる
    4. 4訓練誤差は無視し、そのまま本番に適用する
    答えと解説

    正解: 1

    訓練誤差自体が大きいのは未学習の状態で、正則化が強すぎてモデルが単純になりすぎていると考えられます。正則化の強さはハイパーパラメータなので、弱めて検証データで調整します。正則化を強めたりドロップアウトの割合を上げたりすると、モデルがさらに単純になり悪化します。

  8. 問8
    係数の絶対値の和による罰則(L1正則化)と、係数の二乗和による罰則(L2正則化)を組み合わせた正則化の手法として、最も適切なものを選びなさい。
    1. 1ラッソ回帰
    2. 2Elastic Net
    3. 3リッジ回帰
    4. 4早期終了(early stopping)
    答えと解説

    正解: 2

    L1正則化とL2正則化を組み合わせたものをElastic Netといいます。ラッソ回帰はL1正則化のみで一部の係数をちょうど0にし、リッジ回帰はL2正則化のみで係数を全体的に小さくします。早期終了は検証誤差が上昇に転じた時点で学習を打ち切る手法で、係数への罰則ではありません。