Seq2SeqとAttention
Seq2Seq(エンコーダ・デコーダ)モデルは、入力系列をエンコーダで固定長のベクトルに圧縮し、デコーダで出力系列を生成します。長い入力では固定長ベクトルに情報を押し込めきれず精度が落ちる課題がありました。Attentionは、デコーダが出力の各単語を生成するときに入力のどの部分に注目するかを重み付けして参照する仕組みで、この課題を解決しました。
Self-AttentionとSource-Target Attention
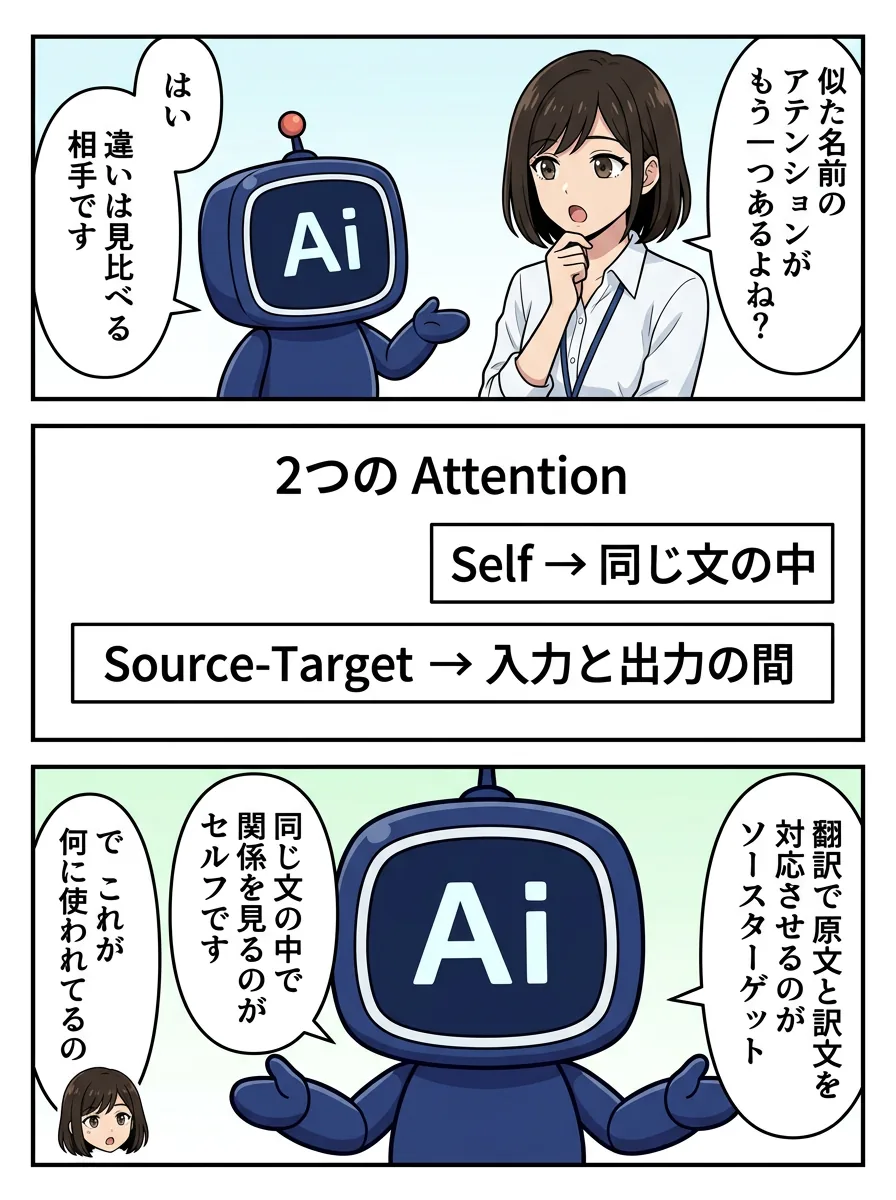
- Source-Target Attention(Encoder-Decoder Attention): クエリがデコーダ側、キーとバリューがエンコーダ側。入力と出力の対応を取る
- Self-Attention: 1つの系列の中で各要素が他の要素とどう関係するかを計算する
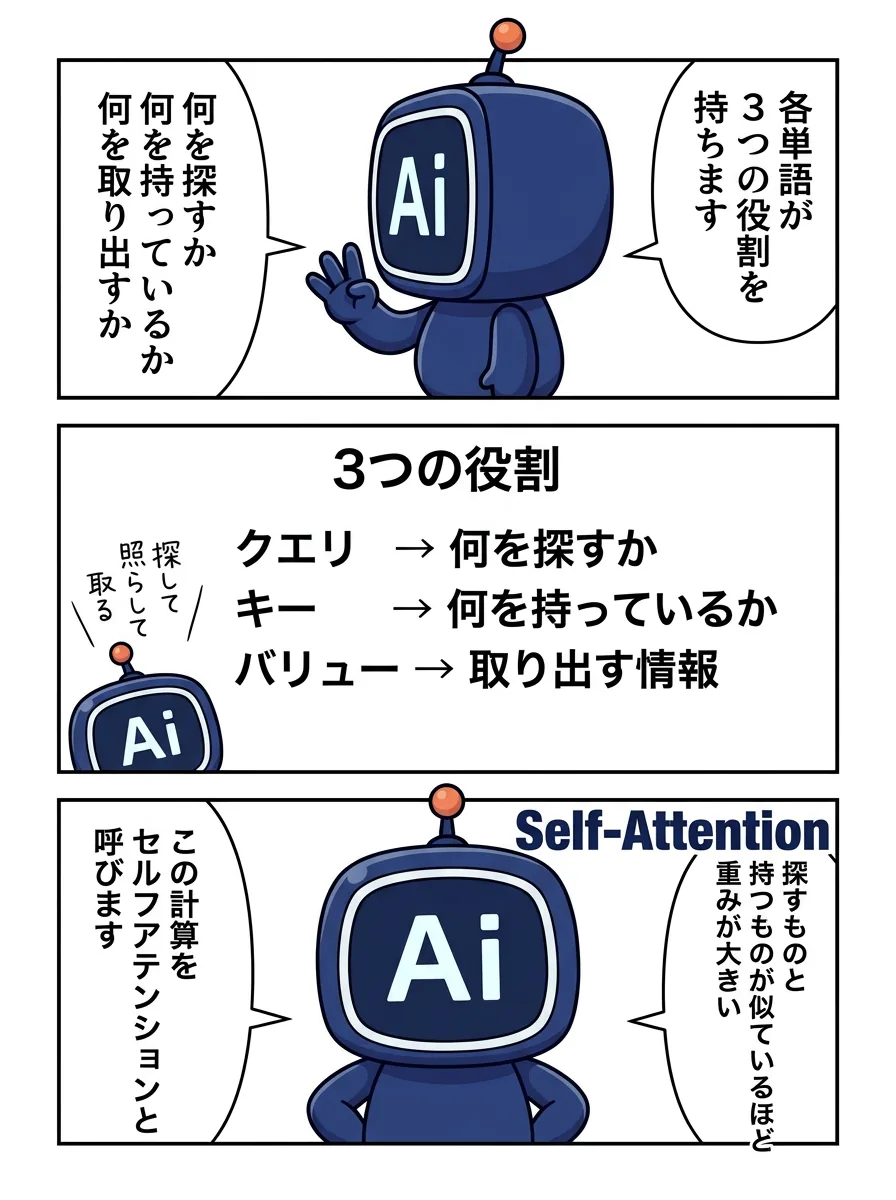
クエリは「何を探しているか」、キーは「各要素が何を持っているか」、バリューは「実際に取り出す情報」です。クエリとキーの類似度で重みを求め、バリューの重み付き和を出力します。
Transformer
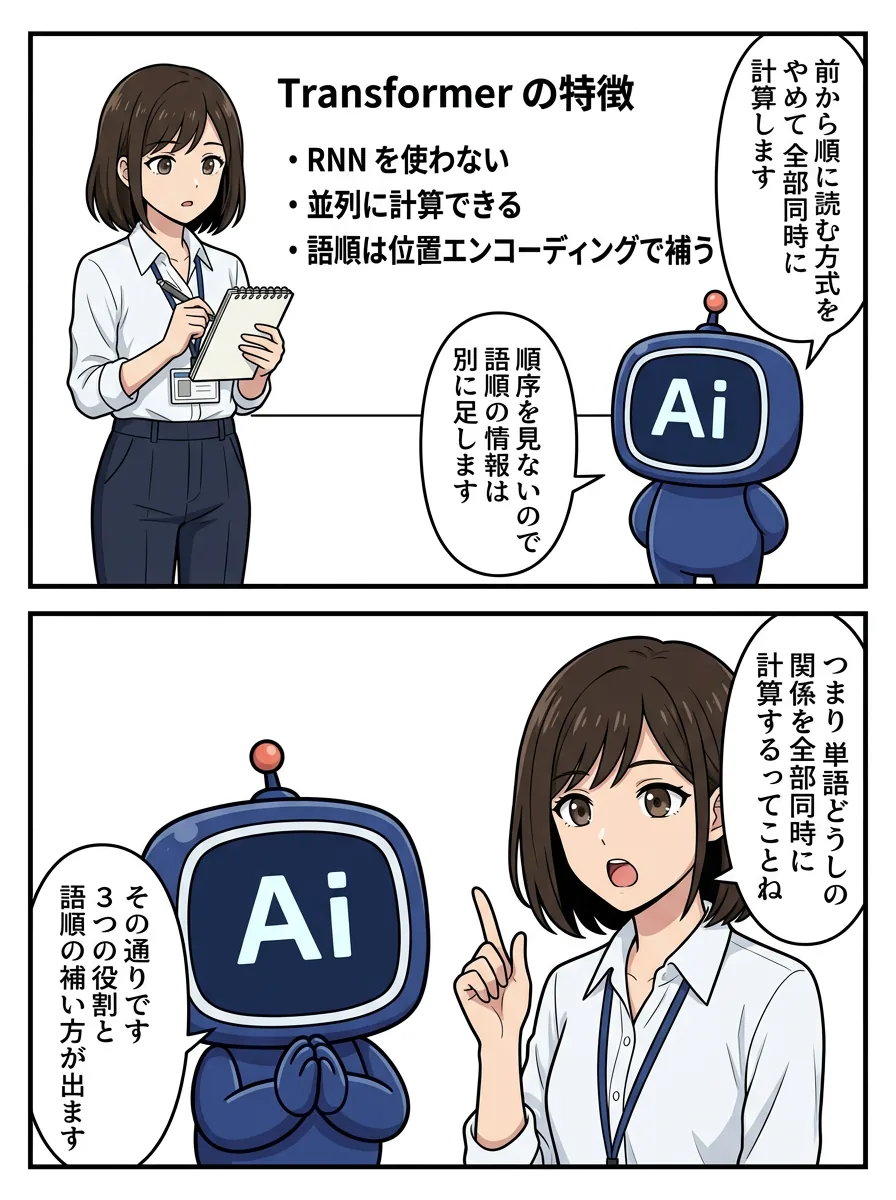
2017年にGoogleが発表した、RNNを使わずAttentionだけで系列を処理するモデルです。
- Self-Attentionは系列内の任意の2点を直接結ぶため、離れた単語の依存関係を捉えやすく、逐次処理が不要で並列計算できる
- Multi-Head Attentionは異なる重みで複数のAttentionを並列に計算して連結し、文法的関係や意味的関係など異なる観点を同時に捉える
- 語順の情報は位置エンコーディングで補う(Self-Attention自体は順序を区別しない)
- 各ブロックには残差結合とレイヤー正規化が含まれる
BERT(エンコーダ)、GPT(デコーダ)、Vision Transformerなど、現在の基盤モデルの多くがTransformerに基づいています。
試験で問われる観点
- Seq2Seqの固定長ベクトルの課題とAttentionによる解決
- クエリ・キー・バリューの役割、Self-AttentionとSource-Target Attentionの違い
- TransformerはRNNを使わない、並列計算、位置エンコーディング
- Multi-Head Attentionの意義