畳み込み操作
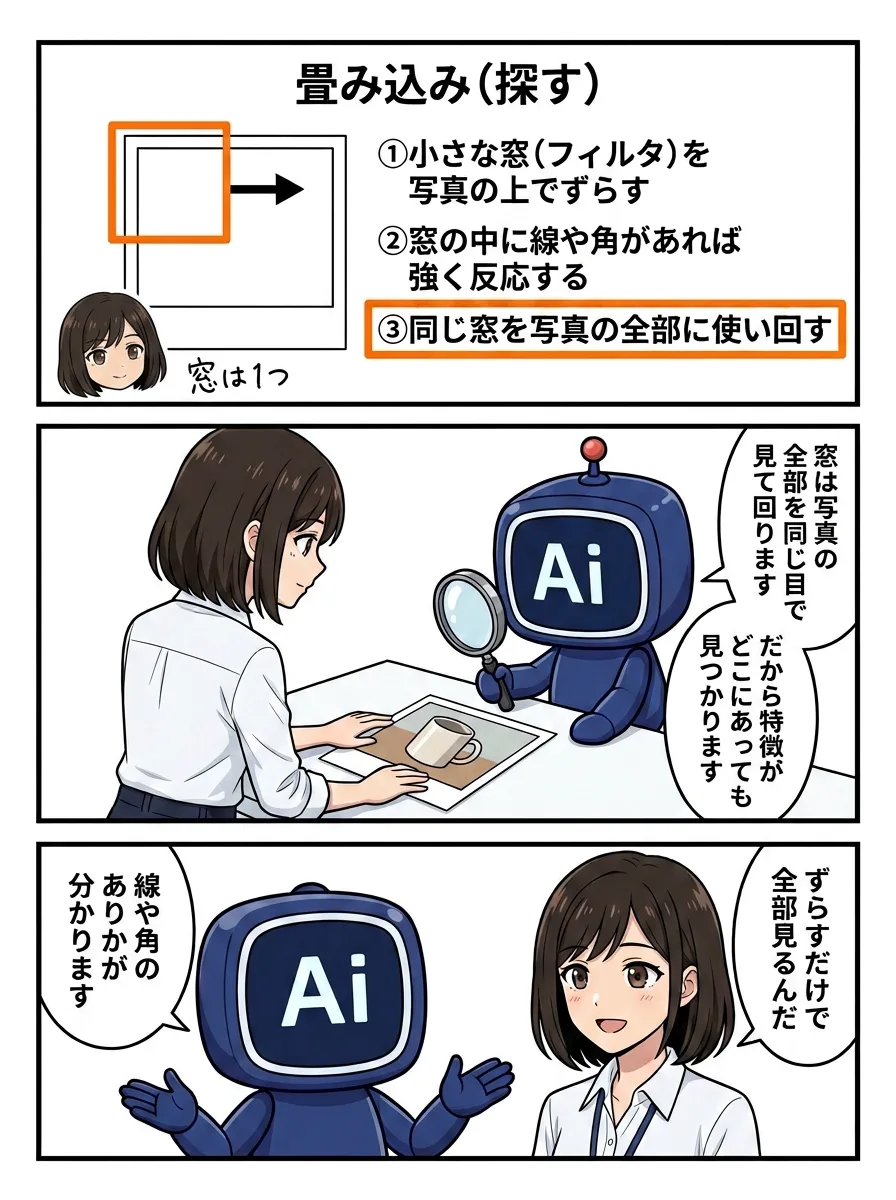
小さなフィルタ(カーネル、例えば3×3)を入力の上でずらしながら、重なる部分の積和を計算して1つの値を出す操作です。出力を特徴マップといい、フィルタの枚数が出力のチャネル数になります。学習によって各フィルタはエッジや模様など異なる特徴に反応するようになります。
ストライドとパディング
- ストライド: フィルタをずらす幅。大きくすると出力が小さくなる
- パディング: 入力の周囲を0などで埋めること。端の情報を使い、出力サイズを保てる
パディングなし・ストライド1のとき、出力サイズは「入力サイズ − フィルタサイズ + 1」です。5×5の入力に3×3のフィルタなら3×3、幅1のゼロパディングを加えると5×5になります。
パラメータ数
フィルタ1枚の重みは「フィルタの縦×横×入力チャネル数」で、これにフィルタ枚数を掛け、フィルタごとのバイアスを足します。RGB入力に3×3のフィルタ16枚なら 3×3×3×16+16 = 448 個です。入力画像のサイズによらない点が全結合層との違いです。
全結合層との違い
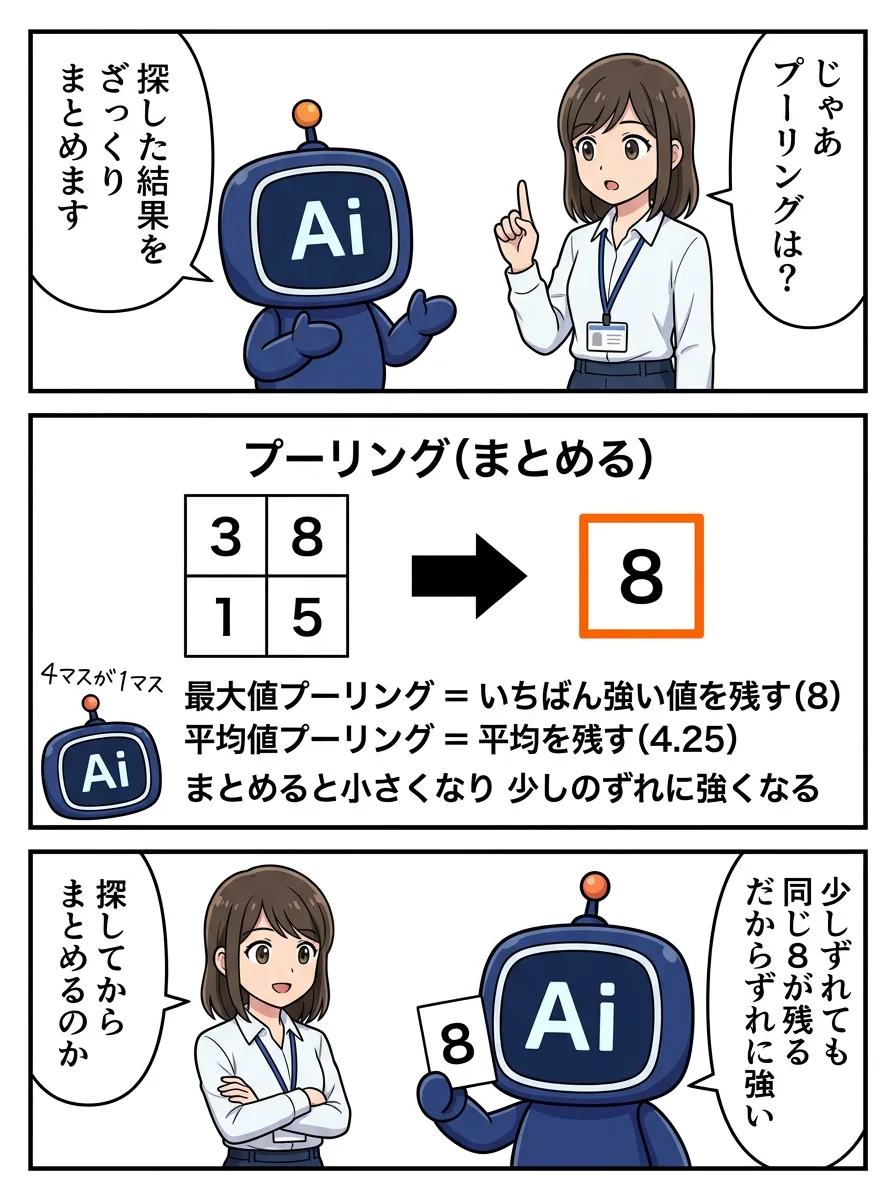
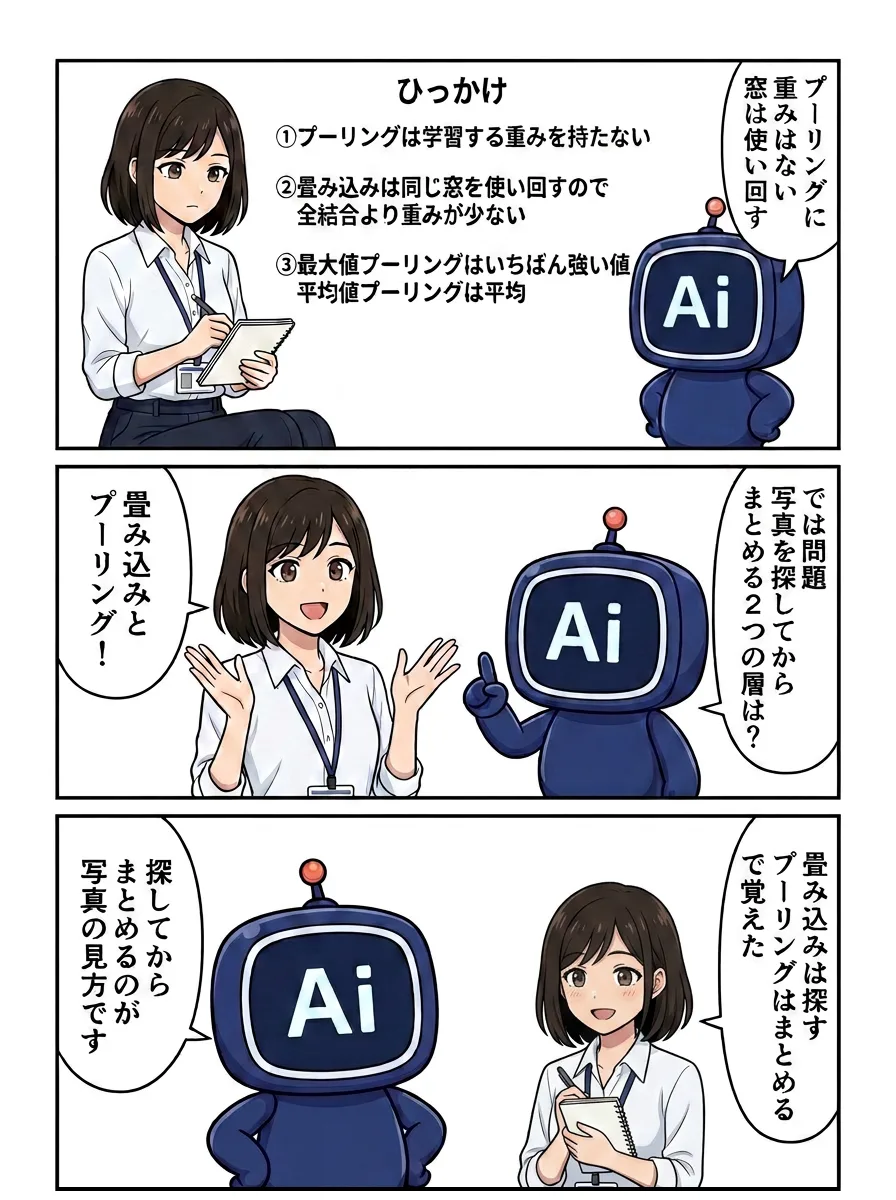
畳み込み層は近くのピクセルだけを見る局所性と、同じフィルタを画像全体で使い回すパラメータ共有によって、パラメータ数を大幅に減らし、位置のずれに強い特徴を抽出します。隣接要素に相関があり、同じパターンがどこに現れても同じ意味を持つデータ(画像、音声のスペクトログラム、時系列)に適しています。
派生手法
- Dilated(Atrous)Convolution: フィルタの要素の間隔を空けて適用し、パラメータを増やさずに広い範囲(受容野)を見る。DeepLabなどのセグメンテーションで使用
- Depthwise Separable Convolution: チャネルごとの空間方向の畳み込みと、1×1のチャネル方向の畳み込みに分けて計算量を削減。MobileNetで使用
試験で問われる観点
- 出力サイズとパラメータ数の計算
- フィルタ枚数=出力チャネル数
- 局所性とパラメータ共有
- Dilated Convolutionは受容野拡大、Depthwise Separableは軽量化