G検定 › Web参考書 › 第4章

活性化関数(シグモイド、tanh、ReLU、Leaky ReLU、ソフトマックスと勾配消失問題)

第4章 ディープラーニングの概要 / 節 2

シラバスのキーワード: シグモイド関数tanh関数ReLU関数Leaky ReLU関数ソフトマックス関数勾配消失問題

本文を読んだあと、覚えているか確認してください。

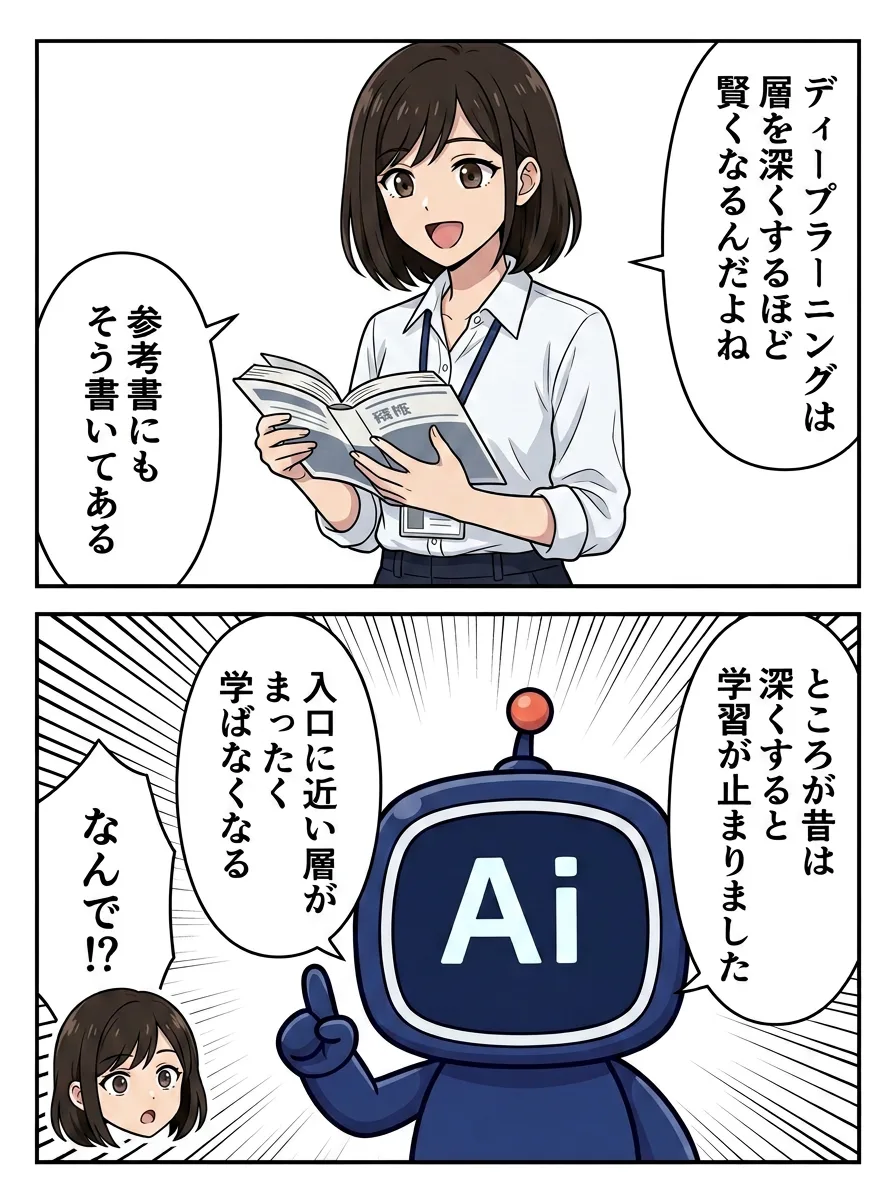
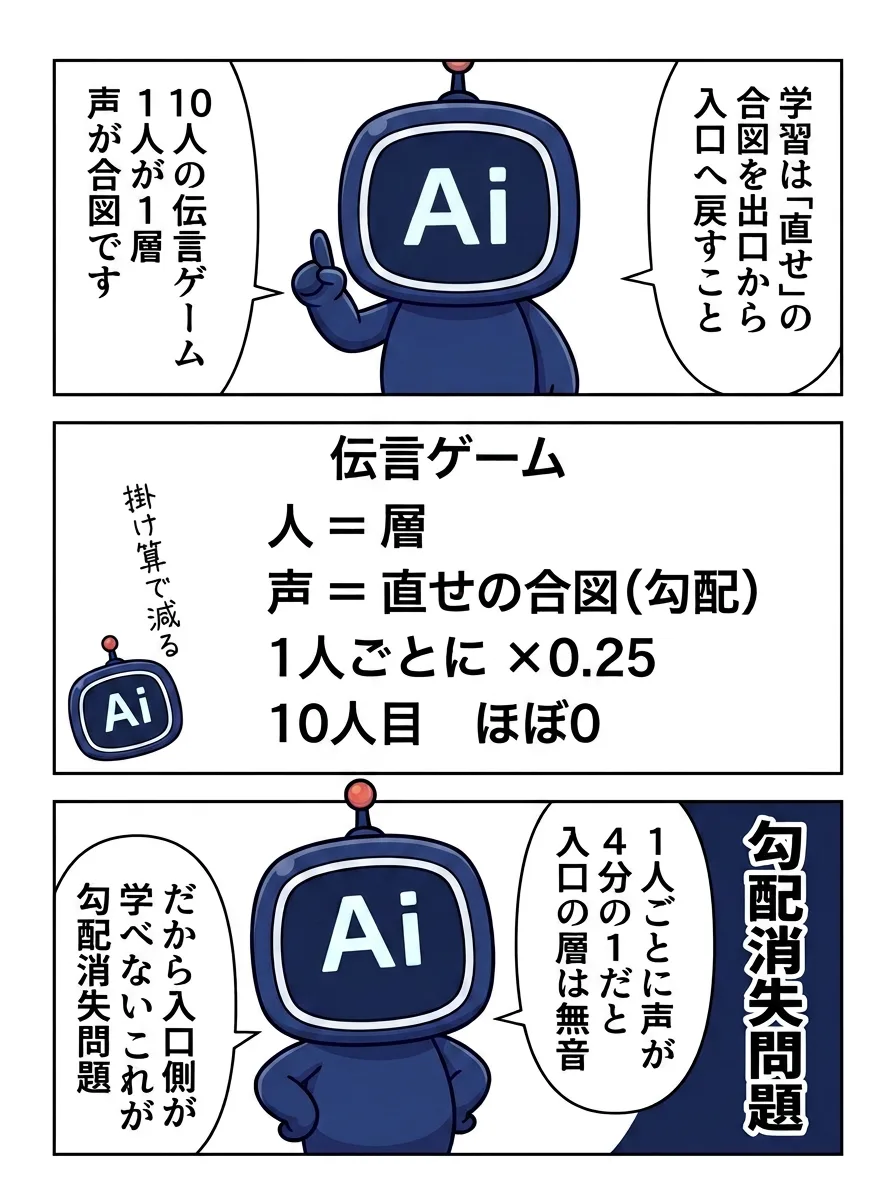
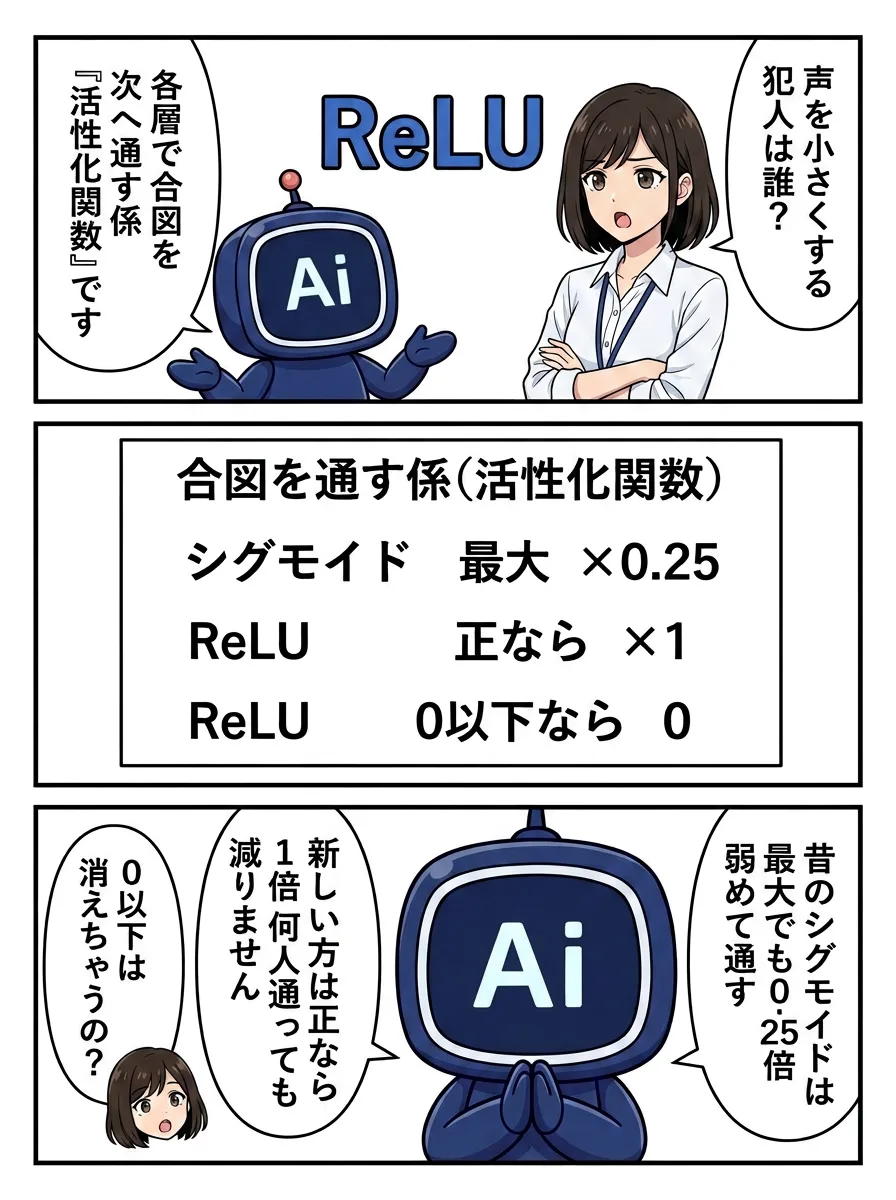
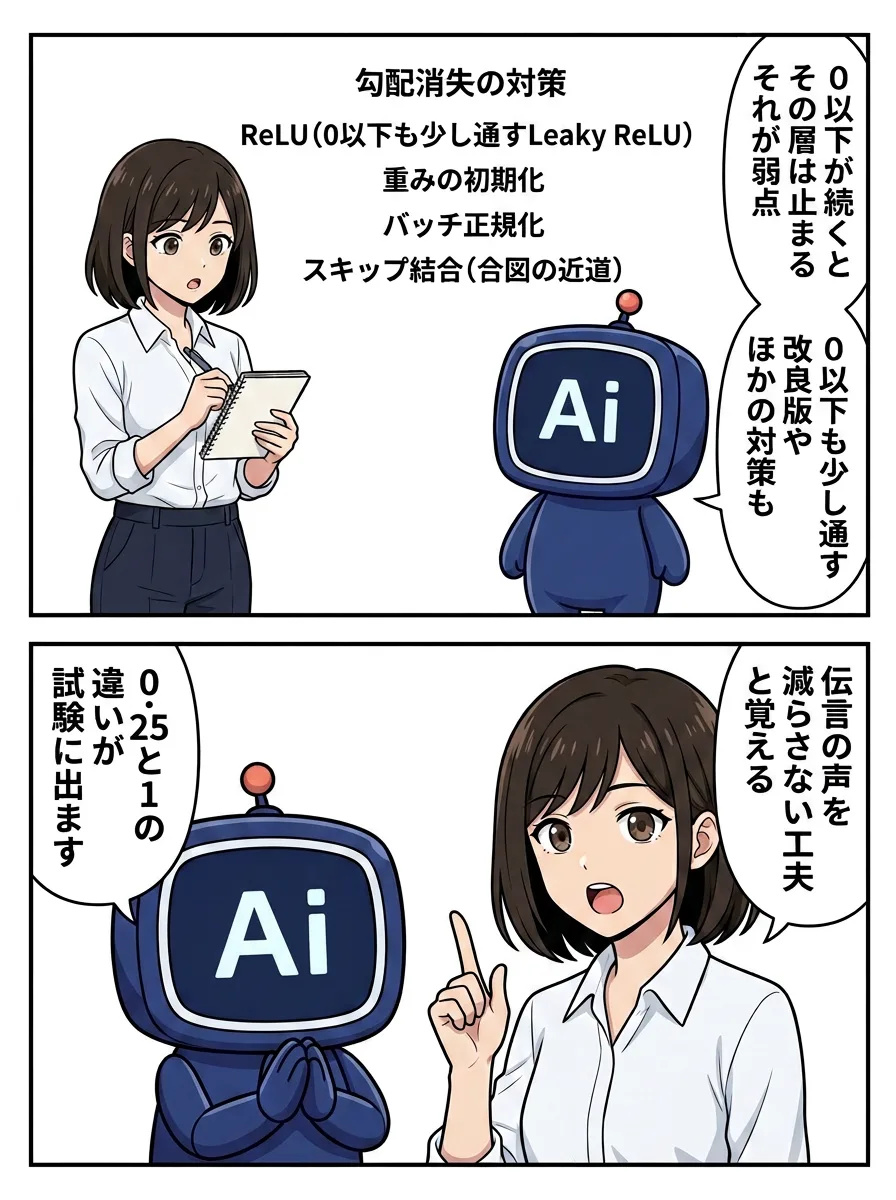
マンガで学ぶ 勾配消失問題

Ai と みお の4ページ。上から順に読んでください。

勾配消失問題の解説マンガ 1/4ページ勾配消失問題の解説マンガ 2/4ページ勾配消失問題の解説マンガ 3/4ページ勾配消失問題の解説マンガ 4/4ページ

このマンガのページ マンガ一覧

活性化関数の役割

線形変換を何回重ねても1つの線形変換にまとまってしまうため、層の間に非線形な活性化関数を挟まなければ多層にする意味がありません。活性化関数が非線形性を導入することで、ニューラルネットワークは複雑な関数を近似できます。

隠れ層で使う関数

関数 出力の範囲 特徴
シグモイド関数 0〜1 滑らかだが、微分の最大値が0.25と小さく、深い層で勾配消失が起きる
tanh関数 −1〜1 原点対称で出力の中心が0のため、シグモイドより学習が進みやすい。それでも入力の絶対値が大きいと勾配がほぼ0になる
ReLU関数 0以上 入力が0以下なら0、正ならそのまま出力。正の領域で勾配が1なので勾配消失が起きにくく、計算も軽い。現在の標準
Leaky ReLU関数 負でもわずかに出力 入力が負のとき小さな傾きを持たせ、ReLUで負の入力のニューロンが学習しなくなる問題(dying ReLU)を緩和

勾配消失問題

誤差逆伝播で勾配は各層の活性化関数の微分を掛け合わせて伝わるため、微分が1より小さい関数を深く重ねると、入力層に近い層ほど勾配が0に近づいて学習が進まなくなります。ReLUの採用、適切な重みの初期化、バッチ正規化、スキップ結合が対策です。

出力層で使う関数

試験で問われる観点

この節の練習問題(8問)

答えを見る前に選んでから開いてください。同じ問題は章別演習でランダム出題されます。

  1. 問1
    シグモイド関数を深いネットワークの隠れ層の活性化関数に用いると、誤差逆伝播の際に勾配が層をさかのぼるほど小さくなり学習が進まなくなる。この現象と、その理由の組み合わせとして最も適切なものを選びなさい。
    1. 1勾配爆発問題。シグモイド関数の微分の最大値が1を超え、層を重ねるごとに掛け合わされて勾配が無限大に発散するため
    2. 2過学習。シグモイド関数が層ごとにパラメータを増やし、訓練データに過剰に適合して検証データでの誤差が下がらないため
    3. 3次元の呪い。シグモイド関数が入力の次元を層ごとに増やし、必要な訓練データの量が指数的に増えて学習が追いつかないため
    4. 4勾配消失問題。シグモイド関数の微分の最大値が0.25と小さく、層を重ねるごとに掛け合わされて勾配が0に近づくため
    答えと解説

    正解: 4

    シグモイド関数の微分は最大でも0.25で、誤差逆伝播では各層の微分が連鎖律で掛け合わされるため、層が深いほど入力側の勾配が指数的に小さくなり、重みが更新されなくなります。これが勾配消失問題で、ディープラーニングが長く実用化できなかった原因の一つです。tanh関数は出力が-1〜1で微分の最大値が1と改善されますが根本解決にはならず、ReLU関数の登場で大きく緩和されました。

  2. 問2
    ReLU関数の特徴と、その弱点を改良した関数の組み合わせとして最も適切なものを選びなさい。
    1. 1入力が0以下なら0、正ならそのまま出力する。正の領域で微分が1なので勾配消失が起きにくいが、負の領域で勾配が0になり学習が止まるノードが出る弱点があり、負の領域にもわずかな傾きを持たせたLeaky ReLUが提案された
    2. 2入力を0〜1の範囲に押し込めるS字型の関数で、出力が確率として解釈できる。ただし入力の絶対値が大きい領域で微分がほぼ0になり、層を重ねると勾配消失が起きやすい弱点があり、出力の中心を0にしたtanh関数が提案された
    3. 3複数の出力の合計が1になるように指数関数で正規化する関数で、多クラス分類の出力層に使われる。ただし出力が最大の要素に集中しやすく確率が極端になる弱点があり、温度パラメータで分布を平滑化する方法が提案された
    4. 4入力を−1〜1の範囲に変換する原点対称のS字型関数で、シグモイドより勾配が大きく学習が進みやすい。ただし入力が大きい領域では微分が0に近づき勾配消失が残る弱点があり、負の領域を指数関数で滑らかにしたELUが提案された
    答えと解説

    正解: 1

    ReLU(Rectified Linear Unit)は max(0, x) で、計算が軽く、正の領域では微分が1なので深い層でも勾配が消えにくいため、隠れ層の標準的な活性化関数になりました。ただし入力が負のノードは勾配0で更新されなくなる(dying ReLU)弱点があり、負の領域に小さな傾き(例: 0.01x)を持たせたLeaky ReLUなどの改良版があります。0〜1に押し込めるS字型の関数はシグモイド、合計が1になるように正規化するのはソフトマックス、−1〜1の原点対称のS字型関数はtanhの説明で、ReLUの説明ではありません。

  3. 問3
    多クラス分類の出力層で、各クラスのスコアを「合計が1になる確率分布」に変換するために用いる活性化関数として最も適切なものを選びなさい。
    1. 1Leaky ReLU関数
    2. 2ソフトマックス関数
    3. 3ReLU関数
    4. 4tanh関数
    答えと解説

    正解: 2

    ソフトマックス関数は、各クラスのスコアの指数をとって全体の合計で割ることで、すべて0〜1でかつ合計が1になる値に変換します。これを各クラスの予測確率として解釈し、交差エントロピー誤差と組み合わせて多クラス分類を学習します。ReLU、tanh、Leaky ReLUは主に隠れ層で使う活性化関数で、確率分布への変換には使いません。2クラス分類の出力層にはシグモイド関数が使われます。

  4. 問4
    tanh関数(双曲線正接関数)の特徴として、最も適切なものを選びなさい。
    1. 1入力が0以下なら0、0より大きければそのまま出力する関数で、勾配が1で一定のため深い層でも勾配消失が起こりにくい
    2. 2各クラスの出力の合計が1になるように変換する関数で、出力を確率として解釈できるため多クラス分類の出力層に使われる
    3. 3出力が0〜1の範囲で原点対称ではなく、シグモイド関数と同じ勾配を持つため、2値分類の出力層で確率を表すのに使われる
    4. 4出力が−1〜1の範囲で原点対称であり、シグモイド関数より勾配が大きいため学習しやすいが、深い層では勾配消失が起こりうる
    答えと解説

    正解: 4

    tanh関数はシグモイド関数を引き伸ばして−1〜1の範囲にした関数で、出力の中心が0になるため隠れ層の活性化関数としてシグモイド関数より学習が進みやすいとされます。ただし入力の絶対値が大きい領域では勾配がほぼ0になるため、深いネットワークでは勾配消失問題が残ります。0〜1の出力はシグモイド関数、正の入力をそのまま通すのはReLU関数、合計が1になるのはソフトマックス関数です。

  5. 問5
    ニューラルネットワークの隠れ層に活性化関数が必要な理由として、最も適切なものを選びなさい。
    1. 1活性化関数がないと層をいくら重ねても全体が1つの線形変換にまとまってしまい、複雑な非線形の関係を表現できないため
    2. 2活性化関数は層ごとのパラメータ数を減らして計算量を抑えるためのもので、表現力や精度には影響せず学習を高速化するため
    3. 3活性化関数は各層の出力を0か1の整数に丸めるために必要で、それがないと分類の出力がクラスとして解釈できないため
    4. 4活性化関数は誤差の大きさに応じて学習率を自動で調整する役割を持ち、それがないと勾配降下法が収束しないため
    答えと解説

    正解: 1

    線形変換を何回重ねても結果は1つの線形変換に等しいため、活性化関数による非線形変換を挟まなければ多層にする意味がありません。活性化関数が非線形性を導入することで、ニューラルネットワークは複雑な関数を近似できます。計算の高速化、整数化、学習率の調整は活性化関数の役割ではありません。

  6. 問6
    タスクと出力層の活性化関数の組み合わせとして最も適切なものを選びなさい。
    1. 12値分類:ソフトマックス関数、多クラス分類:シグモイド関数、回帰:ReLU関数
    2. 22値分類:シグモイド関数、多クラス分類:ソフトマックス関数、回帰:恒等関数(活性化関数なし)
    3. 32値分類:tanh関数、多クラス分類:恒等関数、回帰:ソフトマックス関数
    4. 42値分類:恒等関数、多クラス分類:ReLU関数、回帰:シグモイド関数
    答えと解説

    正解: 2

    2値分類では出力を0〜1の確率にするシグモイド関数、多クラス分類では各クラスの確率の合計を1にするソフトマックス関数を出力層に用います。回帰では任意の実数を出力する必要があるため、恒等関数(活性化関数を適用しない)を使うのが一般的です。ReLUやtanhは主に隠れ層で使う関数です。

  7. 問7
    隠れ層にReLU関数を使ったところ、入力が負になり続けて出力が常に0のまま学習しないニューロンが多く生じた。対策として最も適切なものを選びなさい。
    1. 1シグモイド関数に替え、出力を0〜1の範囲に収めて安定させる
    2. 2出力層の活性化関数を恒等関数に替えて出力を制限しない
    3. 3Leaky ReLU関数に替え、負の入力にも小さな傾きを持たせる
    4. 4活性化関数をなくし、層の数を増やす
    答えと解説

    正解: 3

    負の入力で出力も勾配も0になり学習が止まる現象はdying ReLUと呼ばれ、負の領域に小さな傾きを持たせるLeaky ReLU関数で緩和できます。シグモイド関数は微分が小さく深い層で勾配消失を起こします。出力層を変えても隠れ層の問題は解決せず、活性化関数をなくすと何層重ねても線形変換にまとまってしまいます。

  8. 問8
    住宅価格を予測するニューラルネットワークの出力層にシグモイド関数を使ったところ、出力が0〜1の範囲にしかならなかった。出力層の活性化関数として最も適切なものを選びなさい。
    1. 1恒等関数
    2. 2ソフトマックス関数
    3. 3tanh関数
    4. 4シグモイド関数のまま変えない
    答えと解説

    正解: 1

    回帰問題では予測値の範囲を制限しないよう、出力層には恒等関数を使い、実質的に活性化関数を適用しません。ソフトマックス関数は多クラス分類で各クラスの確率を出す関数です。tanh関数は出力が−1〜1、シグモイド関数は0〜1に収まるため、価格のような連続値の予測には向きません。